时间轴
时间轴
2025-11-13
init
本文介绍了Linux高级字符设备驱动开发中的关键内核机制,包括container_of宏的原理与应用、内核循环双链表数据结构的创建、初始化、添加、删除和遍历操作,以及内核睡眠机制与等待队列的实现方式,为字符设备驱动的阻塞I/O和资源管理提供了基础。
Linux 驱动笔记
| 目录 | 链接 |
|---|---|
| 1. Linux 驱动框架 | |
| 2. Linux 驱动加载逻辑 | |
| 3. 字符设备基础 | |
| 4. 并发与竞争 | |
| 5. 高级字符设备进阶 | |
| 6. 中断 | |
| 7. 平台总线 | |
| 8. 设备树 | |
| 9. 设备模型 | |
| 10. 热插拔 | |
| 11. pinctrl 子系统 | |
| 12. gpio 子系统 | |
| 13. 输入子系统 | |
| 14. 单总线 | |
| 15. I2C | |
| 16. SPI | |
| 17. UART | |
| 18. PWM | |
| 19. RTC | |
| 20. Watchdog | |
| 21. CAN | |
| 22. 网络设备 | |
| 23. ADC | |
| 24. IIO | |
| 25. USB | |
| 26. LCD |
内核工具和辅助函数
container_of 宏
1234567 | // include/linux/kernel.h |
ptr指向结构体中某个成员的指针。type目标结构体类型。member成员在结构体中的名字。BUILD_BUG_ON_MSG(...)编译期类型检查,保证 ptr 和结构体成员类型一致,避免类型错误。__mptr - offsetof(type, member)核心公式:用成员指针减去该成员在结构体中的偏移,得到结构体起始地址。offsetof(type, member)标准宏,计算成员在结构体内的字节偏移。
container_of通过成员指针__mptr减去该成员在结构体中的偏移量offsetof(type, member),得到结构体的起始地址。
链表
一个驱动程序管理多个设备,假设有 5个设备,可能需要在驱动程序中跟踪每个设备,这就需要链表。
内核开发者只实现了循环双链表,因为这个结构能够实现FIFO和LIFO,并且内核开发者要保持最少代码。为了支持链表,代码中要添加的头文件是<linux/list.h>。内核中链表实现核心部分的数据结构是struct list_head,其定义如下:
123 | struct list_head { struct list_head *next, *prev;}; |
struct list_head用在链表头和每个节点中。在内核中,将数据结构表示为链表之前,该结构必须嵌入struct list_head字段。
例子
我们来创建汽车链表:
12345 | struct car { int door_number; char *color; char *model;}; |
在创建汽车链表之前,必须修改其结构,嵌入struct list_head字段。结构变成如下形式:
123456 | struct car { int door_number; char *color; char *model; struct list_head list; /*内核的表结构 */} |
创建struct list_head变量,该变量总是指向链表的头部(第一个元素)。list_head的这个实例与任何汽车都无关,而是一个特殊实例:
1 | static LIST_HEAD(carlist); |
现在可以创建汽车并将其添加到链表carlist:
1234567891011121314 | struct car *redcar = kmalloc(sizeof(*car), GFP_KERNEL);struct car *bluecar = kmalloc(sizeof(*car), GFP_KERNEL);/* 初始化每个节点的列表条目*/INIT_LIST_HEAD(&bluecar->list);INIT_LIST_HEAD(&redcar->list);/* 为颜色和模型字段分配内存,并填充每个字段 */[...]list_add(&redcar->list, &carlist) ;list_add(&bluecar->list, &carlist) ; |
创建和初始化链表
有两种方法创建和初始化链表。
- 动态方法
动态方法由struct list_head组成,用INIT_LIST_HEAD宏初始化:
12 | struct list_head mylist;INIT_LIST_HEAD(&mylist); |
INIT_LIST_HEAD 定义如下
123456789101112 | /** * INIT_LIST_HEAD - Initialize a list_head structure * @list: list_head structure to be initialized. * * Initializes the list_head to point to itself. If it is a list header, * the result is an empty list. */static inline void INIT_LIST_HEAD(struct list_head *list){ WRITE_ONCE(list->next, list); list->prev = list;} |
- 静态方法
静态分配通过LIST_HEAD宏完成:
1 | LIST_HEAD(mylist) |
LIST_HEAD 定义如下
1234 |
这为name字段内的每个指针(prev和next)赋值,使其指向name自身(就像INIT_LIST_HEAD做的那样)
创建链表节点
要创建新节点,只需创建数据结构实例,初始化嵌入在其中的list_head字段。以汽车为例,其代码如下:
1234 | struct car *blackcar = kzalloc(sizeof(struct car), GFP_KERNEL);/* 非静态初始化,因为它是嵌入的列表字段*/INIT_LIST_HEAD(&blackcar->list); |
添加链表节点
内核提供的list_add()用于向链表添加新项,它是内部函数__list_add的包装:
12345678910111213141516171819202122232425262728293031 | /* * Insert a new entry between two known consecutive entries. * * This is only for internal list manipulation where we know * the prev/next entries already! */static inline void __list_add(struct list_head *new, struct list_head *prev, struct list_head *next){ if (!__list_add_valid(new, prev, next)) return; next->prev = new; new->next = next; new->prev = prev; WRITE_ONCE(prev->next, new);}/** * list_add - add a new entry * @new: new entry to be added * @head: list head to add it after * * Insert a new entry after the specified head. * This is good for implementing stacks. */static inline void list_add(struct list_head *new, struct list_head *head){ __list_add(new, head, head->next);} |
下面的例子在链表中添加两辆车:
12 | list_add(&redcar->list, &carlist);list_add_tail(&bluecar->list, &carlist); |
将节点添加到链表尾部的函数,代码如下:
123456789101112 | /** * list_add_tail - add a new entry * @new: new entry to be added * @head: list head to add it before * * Insert a new entry before the specified head. * This is useful for implementing queues. */static inline void list_add_tail(struct list_head *new, struct list_head *head){ __list_add(new, head->prev, head);} |
这将把指定新项插入链表的末尾。对于之前的例子,可以使用以下代码:
12 | list_add_tail(&redcar->list, &carlist);list_add_tail(&bluecar->list, &carlist); |
这种模式可以用来实现队列(FIFO)
删除链表节点
内核代码中的链表处理是一项简单的任务。删除节点很简单:
123456789101112 | /** * list_del - deletes entry from list. * @entry: the element to delete from the list. * Note: list_empty() on entry does not return true after this, the entry is * in an undefined state. */static inline void list_del(struct list_head *entry){ __list_del_entry(entry); entry->next = LIST_POISON1; entry->prev = LIST_POISON2;} |
删除红色车:
1 | list_del(&redcar->list); |
list_del 断开指定节点的 prev 和 next 指针,移除该节点。分配给该节点的内存需要使用 kfree 手动释放。
链表遍历
使用宏list_for_each_entry(pos, head, member)进行链表遍历。
pos:用于迭代。head:链表的头节点。member:数据结构(在我们的例子中,它是struct car中定义的 list)中链表struct list_head的名称。
123456789 | struct car *acar; /* 循环计数器*/int blue_car_num = 0;/* list 是数据结构中的list_head结构的名称 */list_for_each_entry(acar, carlist, list){ if(acar->color == "blue") blue_car_num++;} |
list_for_each_entry定义如下:
1234567891011 | /** * list_for_each_entry - iterate over list of given type * @pos: the type * to use as a loop cursor. * @head: the head for your list. * @member: the name of the list_head within the struct. */ |
内核的睡眠机制
进程通过睡眠机制释放处理器,使其能够处理其他进程。处理器睡眠的原因可能在于感知数据的可用性,或等待资源释放。
内核调度器管理要运行的任务列表,这被称作运行队列。睡眠进程不再被调度,因为已将它们从运行队列中移除。除非其状态改变(唤醒),否则睡眠进程将永远不会被执行。进程一旦进入等待状态,就可以释放处理器,一定要确保有条件或其他进程会唤醒它。
Linux 内核通过提供一组函数和数据结构来简化睡眠机制的实现。
等待队列
等待队列实际上用于处理被阻塞的I/O,以等待特定条件成立,并感知数据或资源可用性。
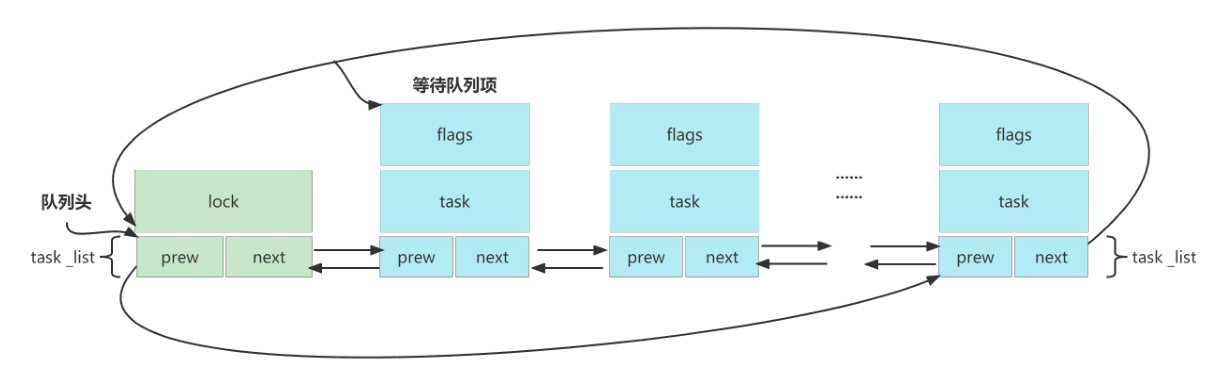
等待队列是实现阻塞和唤醒的内核机制,等待队列以双循环链表为基础结构,其中链表头和链表项两部分别表示等待队列头和等待队列元素。
定义
include/linux/wait.h
12345678910111213141516 | typedef struct wait_queue_entry wait_queue_entry_t;struct wait_queue_entry { unsigned int flags; void *private; wait_queue_func_t func; struct list_head entry;};struct wait_queue_head { spinlock_t lock; struct list_head head;};typedef struct wait_queue_head wait_queue_head_t;struct task_struct; |
初始化等待队列
| API | 用途 | 说明 / 参数 | 注意事项 |
|---|---|---|---|
DECLARE_WAIT_QUEUE_HEAD(name) | 静态定义等待队列头 | 生成一个名为name的全局/静态等待队列头 | 最常用方式 |
init_waitqueue_head(wq) | 动态初始化等待队列头 | 适用于动态分配结构体中的等待队列头 | 需要先分配内存 |
等待队列项API
这类API大部分情况下不用用到,task一般是current
| API | 用途 | 说明 / 参数 | 注意事项 |
|---|---|---|---|
DECLARE_WAITQUEUE(name, task) | 静态创建一个等待队列项 | task通常填current | 全局或静态场景 |
init_waitqueue_entry(&entry, task) | 动态初始化队列项 | task 通常为current | 动态创建项 |
add_wait_queue(head, entry) | 将等待项加入等待队列 | 非排他 wait | 多用于底层调用(不建议直接用) |
add_wait_queue_exclusive(head, entry) | 排他 wait | 唤醒时只唤醒 1 个 exclusive 进程 | 用于写操作等阻塞队列 |
remove_wait_queue(head, entry) | 从等待队列移除项 | 和 add_wait_queue 配对 |
睡眠等待API
| API | 用途 | 说明 | 返回值 / 注意事项 |
|---|---|---|---|
wait_event(wq, condition) | 条件不满足 → 睡眠(不可中断) | condition 为真返回 | 不能被信号打断 |
wait_event_timeout(wq, condition, timeout) | 不可中断睡眠 + 超时 | timeout 为 jiffies | 返回剩余 jiffies 或 0 超时 |
wait_event_interruptible(wq, condition) | 可中断睡眠 | 可被信号打断 | 被打断时返回-ERESTARTSYS |
wait_event_interruptible_timeout(wq, condition, timeout) | 可中断 + 超时 | 返回:>0 剩余时间,0 超时,<0 被信号打断 | |
wait_event_killable(wq, condition) | 仅 fatal signal 打断 | 比 interruptible 更安全 | 被杀死信号打断 |
wait_event_killable_timeout(wq, condition, timeout) | killable + timeout | 同上 |
wait_event_interruptible不会持续轮询,而只是在被调用时评估条件。如果条件为假,则进程将进入TASK_INTERRUPTIBLE状态并从运行队列中删除。
之后,当每次在等待队列中调用wake_up_interruptible时,都会重新检查条件。如果wake_up_interruptible运行时发现条件为真,则等待队列中的进程将被唤醒,并将其状态设置为TASK_RUNNING。进程按照它们进入睡眠的顺序唤醒。
要唤醒在队列中等待的所有进程,应该使用wake_up_interruptible_all
如果调用了wake_up或wake_up_interruptible,并且条件仍然是FALSE,则什么都不会发生。如果没有调用wake_up(或wake_up_interruptible),进程将永远不会被唤醒。
wait_event、wake_up 和 wake_up_all。它们以独占(不可中断)等待的方式处理队列中的进程,因为它们不能被信号中断。它们只能用于关键任务。
可中断函数只是可选的(但推荐使用),由于它们可以被信号中断,所以应该检查它们的返回值。非零值意味着睡眠被某种信号中断,驱动程序应该返回
ERESTARTSYS。
唤醒API
| API | 用途 | 说明 / 参数 | 唤醒规则 |
|---|---|---|---|
wake_up(&wq) | 唤醒 queue 中所有非 exclusive waiter | 不修改任务状态 | 适合读者多、唤醒不需要限制 |
wake_up_all(&wq) | 唤醒所有 waiter | 包含 exclusive | 强制唤醒所有任务 |
wake_up_interruptible(&wq) | 唤醒TASK_INTERRUPTIBLE状态任务 | 适配 interruptible wait | |
wake_up_interruptible_all(&wq) | 唤醒所有可中断等待者 | ||
wake_up_nr(&wq, nr) | 唤醒 nr 个 exclusive waiter | 最常用:wake_up(&wq) | exclusive 只唤醒一个 |
等待队列里有两类等待者:
| 类型 | 怎么来的 | 典型场景 |
|---|---|---|
| 非 exclusive | add_wait_queue() | 多读者(read) |
| exclusive | add_wait_queue_exclusive() | 写者、资源竞争 |
exclusive 的设计目标是:
避免“惊群(thundering herd)”
延迟和定时器管理
时间是继内存之后常用的资源之一。它用于执行几乎所有的事情:延迟工作、睡眠、调度、超时以及许多其他任务。
时间有两类。内核使用绝对时间来了解具体时间,也就是一天的日期和时间,而相对时间则被内核调度程序使用。
- 对于绝对时间,有一个称为实时时钟(RTC)的硬件芯片。
- 为了处理相对时间,内核依赖于被称作定时器的CPU功能(外设),从内核的角度来看,它被称为内核定时器。
内核定时器分为两个不同的部分。
- 标准定时器或系统定时器。
- 高精度定时器。
Linux 内核标准定时器
标准定时器是内核定时器,它以Jiffy为粒度运行。
硬件为内核提供了一个系统定时器来计算流逝的时间(即基于未来时间点的计时方式,以当前时刻为计时开始的起点,以未来的某一时刻为计时的终点),内核只有在系统定时器的帮助下才能计算和管理时间,但是内核定时器的精度并不高,所以不能作为高精度定时器使用。
并且内核定时器的运行没有周期性,到达计时终点后会自动关闭。如果要实现周期性定时,就要在定时处理函数中重新开启定时器。
定义
Linux 内核中使用 timer_list 结构体表示内核定时器
include/linux/timer.h
1234567891011121314 | struct timer_list { /* * All fields that change during normal runtime grouped to the * same cacheline */ struct hlist_node entry; unsigned long expires; void (*function)(struct timer_list *); u32 flags; struct lockdep_map lockdep_map;}; |
DEFINE_TIMER
123456789101112 | // include/linux/timer.h |
可以使用以下代码对定时器和相应的定时处理函数进行定义
1 | DEFINE_TIMER(timer_test,function_test);//定义一个定时器 |
timer_setup()
| 项目 | 说明 |
|---|---|
| 函数定义 | void timer_setup(struct timer_list *timer, void (*callback)(struct timer_list *), unsigned int flags); |
| 头文件 | #include <linux/timer.h> |
| 参数 timer | 要初始化的struct timer_list定时器对象 |
| 参数 callback | 定时器到期后执行的回调函数,类型为void (*)(struct timer_list *) |
| 参数 flags | 定时器标志位(如TIMER_DEFERRABLE、TIMER_PINNED等) |
| 功能 | 初始化一个定时器对象,为第一次使用做准备,设置回调函数和标志位 |
| 返回值 | 无返回值(void) |
| 说明 | 仅完成初始化,不会启动定时器;需配合add_timer()或mod_timer()才会开始计时 |
timer_setup_on_stack()
| 项目 | 说明 |
|---|---|
| 函数定义 | void timer_setup_on_stack(struct timer_list *timer, void (*callback)(struct timer_list *), unsigned int flags); |
| 头文件 | #include <linux/timer.h> |
| 参数 timer | 位于栈上的struct timer_list定时器对象 |
| 参数 callback | 定时器到期后执行的回调函数 |
| 参数 flags | 定时器标志位 |
| 功能 | 初始化一个栈上分配的定时器对象 |
| 返回值 | 无返回值(void) |
| 注意事项 | 必须与destroy_timer_on_stack()成对使用,否则会导致内核调试警告或资源问题 |
destroy_timer_on_stack()
| 项目 | 说明 |
|---|---|
| 函数定义 | static inline void destroy_timer_on_stack(struct timer_list *timer); |
| 头文件 | #include <linux/timer.h> |
| 参数 timer | 位于栈上的struct timer_list定时器对象 |
| 功能 | 销毁一个通过timer_setup_on_stack()初始化的栈上定时器 |
| 返回值 | 无返回值(void) |
| 使用场景 | 仅用于栈上分配的定时器(非堆/全局变量) |
| 注意事项 | 必须与timer_setup_on_stack()成对使用 |
add_timer()
| 项目 | 说明 |
|---|---|
| 函数定义 | void add_timer(struct timer_list *timer); |
| 头文件 | #include <linux/timer.h> |
| 参数 timer | 一个已初始化好的定时器对象,必须设置expires(到期时间) 和function(回调函数) |
| 功能 | 将定时器注册到内核,使其开始计时。当expires到达时触发回调函数 |
| 返回值 | 无返回值(void) |
del_timer()
| 项目 | 说明 |
|---|---|
| 函数定义 | int del_timer(struct timer_list *timer); |
| 头文件 | #include <linux/timer.h> |
| 参数 timer | 需要删除的定时器对象 |
| 功能 | 从内核中删除定时器,使其不再触发。不会等待回调执行结束(如需等待请使用del_timer_sync()) |
| 返回值 | 成功删除:1(定时器处于激活状态)已经不在激活队列:0 |
注意:从内核中删除定时器,使其不再触发。如果要等待回调执行结束要使用del_timer_sync(),等待处理程序(即使是在另一个CPU上执行)执行完成。不应该持有阻止处理程序完成的锁,这样将导致死锁。
应该在模块清理例程中释放定时器。可以调用timer_pending()函数独立检查定时器是否正在运行
timer_pending()
这个函数检查是否有触发的定时器回调函数挂起。
| 项目 | 说明 |
|---|---|
| 函数定义 | static inline int timer_pending(const struct timer_list *timer); |
| 头文件 | #include <linux/timer.h> |
| 参数 timer | 要检查状态的struct timer_list定时器对象 |
| 功能 | 判断该定时器当前是否处于“等待触发(pending)”状态 |
| 返回值 | 若定时器已加入内核定时器队列(正在计时)返回 1;否则返回 0 |
| 注意事项 | 调用者必须保证对该定时器的访问已做并发保护(如加锁或在同一上下文中) |
mod_timer()
| 项目 | 说明 |
|---|---|
| 函数定义 | int mod_timer(struct timer_list *timer, unsigned long expires); |
| 头文件 | #include <linux/timer.h> |
| 参数 timer | 需要修改的定时器对象 |
| 参数 expires | 新的到期时间(单位:jiffies) |
| 功能 | 修改定时器的到期时间。如果定时器未激活,会自动激活。如果已激活,会重新开始计时 |
| 返回值 | 修改前定时器已激活:1 修改前定时器未激活:0 |
在使用 add_timer()函数向 Linux 内核注册定时器之前,还需要设置定时时间,定时时间由 timer_list 结构体中的 expires 参数所确定,单位为节拍数,可以通过Linux编译时图形化界面menuconfig设置系统节拍的频率,具体路径如下所示:
12 | -> Kernel Features -> Timer frequency (<choice> [=y]) |
当前版本内核代码可选的系统节拍率为 100Hz、250Hz、300Hz 和 1000Hz,默认情况下选择300Hz。
全局变量 jiffies
通过全局变量 jiffies 来记录自系统启动以来产生节拍的总数。jiffies_64 用于 64 位系统,而 jiffies 用于 32 位系统。启动时,内核将该变量初始化为 0,此后,每次时钟中断处理程序都会增加该变量的值,一秒内 jiffes 增加的值为设置的系统节拍数,该变量定义在include/linux/jiffies.h文件中(timer.h 文件中已经包含,不需要重复引用),具体定义如下:
12 | extern u64 __cacheline_aligned_in_smp jiffies_64;extern unsigned long volatile __cacheline_aligned_in_smp __jiffy_arch_data jiffies; |
jiffies 与时间单位转换函数
| 函数定义 | 作用 |
|---|---|
| int jiffies_to_msecs(const unsigned long j) | 将jiffies类型的参数j转换为对应的毫秒 |
| int jiffies_to_usecs(const unsigned long j) | 将jiffies类型的参数j转换为对应的微秒 |
| u64 jiffies_to_nsecs(const unsigned long j) | 将jiffies类型的参数j转换为对应的纳秒 |
| long msecs_to_jiffies(const unsigned int m) | 将毫秒转换为jiffies类型 |
| long usecs_to_jiffies(const unsigned int u) | 将微秒转换为jiffies类型 |
| unsigned long nsecs_to_jiffies(u64 n) | 将纳秒转换为jiffies类型 |
示例
123456789101112131415161718192021222324252627282930313233343536373839404142434445464748495051525354555657585960616263646566676869707172737475767778798081828384858687888990919293949596979899100101102103104105106107108109110111112113114115116117118119120121122123124125126127128129 | struct drv_data { dev_t dev_num; struct cdev cdev; struct class *class; struct device *dev;};static struct drv_data *drv_dat;static void timer_irq_func(struct timer_list *t);DEFINE_TIMER(timer_test, timer_irq_func);int timer_mod_test_open(struct inode *inode, struct file *file){ file->private_data = drv_dat; pr_info("open is called by pid: %d\n", task_pid_nr(current)); return 0;}ssize_t timer_mod_test_read(struct file *file, char __user *buf, size_t size, loff_t *offset){ size_t len = min(sizeof(u64) + 1, size); char kbuf[72]; snprintf(kbuf, sizeof(kbuf), "%llu", (unsigned long long)jiffies_to_msecs(get_jiffies_64())); if (copy_to_user(buf, kbuf, len) != 0) return -EFAULT; pr_info("read is called by pid: %d\n", task_pid_nr(current)); return len;}int timer_mod_test_release(struct inode *inode, struct file *file){ pr_info("release is called by pid: %d\n", task_pid_nr(current)); return 0;}struct file_operations fops = { .owner = THIS_MODULE, .open = timer_mod_test_open, .read = timer_mod_test_read, .release = timer_mod_test_release,};static void timer_irq_func(struct timer_list *t){ pr_info("timer_irq_func is called\n"); mod_timer(&timer_test, jiffies_64 + msecs_to_jiffies(3000));}static int __init timer_mod_test_init(void){ int ret; drv_dat = kzalloc(sizeof(struct drv_data), GFP_KERNEL); if (drv_dat == NULL) { ret = -ENOMEM; goto kzalloc_fail; } ret = alloc_chrdev_region(&drv_dat->dev_num, 1, 0, "timer_mod_test_chrdev_region"); if (ret < 0) goto alloc_chrdev_region_fail; cdev_init(&drv_dat->cdev, &fops); drv_dat->cdev.owner = THIS_MODULE; ret = cdev_add(&drv_dat->cdev, drv_dat->dev_num, 1); if (ret < 0) goto cdev_add_fail; drv_dat->class = class_create(THIS_MODULE, "chrdev"); if (IS_ERR(drv_dat->class)) { ret = PTR_ERR(drv_dat->class); goto class_create_fail; } drv_dat->dev = device_create(drv_dat->class, NULL, drv_dat->dev_num, NULL, "timer_test%d", 0); if (IS_ERR(drv_dat->dev)) { ret = PTR_ERR(drv_dat->dev); goto device_create_fail; } // 把timer_test设置为5s后 timer_test.expires = jiffies_64 + msecs_to_jiffies(3000); // 添加一个定时器 add_timer(&timer_test); return 0;device_create_fail: class_destroy(drv_dat->class);class_create_fail: cdev_del(&drv_dat->cdev);cdev_add_fail: unregister_chrdev_region(drv_dat->dev_num, 1);alloc_chrdev_region_fail: kfree(drv_dat);kzalloc_fail: return ret;}static void __exit timer_mod_test_exit(void){ // 删除定时器 del_timer(&timer_test); device_destroy(drv_dat->class, drv_dat->dev_num); class_destroy(drv_dat->class); cdev_del(&drv_dat->cdev); unregister_chrdev_region(drv_dat->dev_num, 1); kfree(drv_dat);}module_init(timer_mod_test_init);module_exit(timer_mod_test_exit);MODULE_LICENSE("GPL");MODULE_AUTHOR("even629<asqwgo@outlook.com>");MODULE_DESCRIPTION("This is a test sample for linux timer"); |
可以利用原子变量和timer做一个定时器,示例如下:
123456789101112131415161718192021222324252627282930313233343536373839404142434445464748495051525354555657585960616263646566676869707172737475767778798081828384858687888990919293949596979899100101102103104105106107108109110111112113114115116117118119120121122123124125126127128129130131132133 | struct timer_drv_data { dev_t dev_num; struct cdev cdev; struct class *class; struct device *dev; atomic64_t sec;};static struct timer_drv_data *timer_drv_data;static void timer_sec_func(struct timer_list *t);DEFINE_TIMER(timer_sec, timer_sec_func);int timer_sec_test_open(struct inode *inode, struct file *file){ file->private_data = timer_drv_data; // 初始化为0 atomic64_set(&timer_drv_data->sec, 0); add_timer(&timer_sec); pr_info("open is called by pid: %d\n", task_pid_nr(current)); return 0;}ssize_t timer_sec_test_read(struct file *file, char __user *buf, size_t size, loff_t *offset){ struct timer_drv_data *dat = file->private_data; size_t len; char kbuf[128]; snprintf(kbuf, sizeof(kbuf), "current sec: %llu\n", atomic64_read(&dat->sec)); len = min(size, strlen(kbuf) + 1); if (copy_to_user(buf, kbuf, len) != 0) return -EFAULT; return len;}int timer_sec_test_release(struct inode *inode, struct file *file){ del_timer(&timer_sec); pr_info("release is called by pid: %d\n", task_pid_nr(current)); return 0;}struct file_operations fops = { .owner = THIS_MODULE, .open = timer_sec_test_open, .read = timer_sec_test_read, .release = timer_sec_test_release,};static void timer_sec_func(struct timer_list *t){ atomic64_inc(&timer_drv_data->sec); mod_timer(&timer_sec, get_jiffies_64() + msecs_to_jiffies(1000));}static int __init timer_sec_init(void){ int ret; timer_drv_data = kzalloc(sizeof(struct timer_drv_data), GFP_KERNEL); if (timer_drv_data == NULL) { ret = -ENOMEM; goto kzalloc_fail; } ret = alloc_chrdev_region(&timer_drv_data->dev_num, 0, 1, "test_chrdev_region"); if (ret < 0) goto alloc_chrdev_region_fail; cdev_init(&timer_drv_data->cdev, &fops); timer_drv_data->cdev.owner = THIS_MODULE; ret = cdev_add(&timer_drv_data->cdev, timer_drv_data->dev_num, 1); if (ret < 0) goto cdev_add_fail; timer_drv_data->class = class_create(THIS_MODULE, "chrdev"); if (IS_ERR(timer_drv_data->class)) { ret = PTR_ERR(timer_drv_data->class); goto class_create_fail; } timer_drv_data->dev = device_create(timer_drv_data->class, NULL, timer_drv_data->dev_num, NULL, "timer_sec%d", 0); if (IS_ERR(timer_drv_data->dev)) { ret = PTR_ERR(timer_drv_data->dev); goto device_create_fail; } return 0;device_create_fail: class_destroy(timer_drv_data->class);class_create_fail: cdev_del(&timer_drv_data->cdev);cdev_add_fail: unregister_chrdev_region(timer_drv_data->dev_num, 1);alloc_chrdev_region_fail: kfree(timer_drv_data);kzalloc_fail: return ret;}static void __exit timer_sec_exit(void){ class_destroy(timer_drv_data->class); cdev_del(&timer_drv_data->cdev); unregister_chrdev_region(timer_drv_data->dev_num, 1); kfree(timer_drv_data);}module_init(timer_sec_init);module_exit(timer_sec_exit);MODULE_LICENSE("GPL");MODULE_AUTHOR("even629<asqwgo@outlook.com>");MODULE_DESCRIPTION("This is a sec timer"); |
Linux 高精度定时器 HRT
hrtimer= **High Resolution Timer(高精度定时器)**由内核配置中的CONFIG_HIGH_RES_TIMERS选项启用,特点如下:
- 纳秒级精度(基于 ktime)
- 适用于高精度周期任务
- 运行在软中断上下文
- 可周期性或单次触发
与传统timer_list区别:
| 项目 | timer_list | hrtimer |
|---|---|---|
| 精度 | jiffies 级别 | 纳秒级 |
| 精度依赖 | HZ | 硬件高精度时钟 |
| 适合 | 普通延时 | 高精度周期任务 |
单位 符号 等于多少秒 应用场景 毫秒 ms 10⁻³ 秒 = 0.001 s 计算机响应、音频 微秒 μs 10⁻⁶ 秒 电子、网络延迟 纳秒 ns 10⁻⁹ 秒 CPU 时钟周期、光传播 皮秒 ps 10⁻¹² 秒 激光、量子物理 飞秒 fs 10⁻¹⁵ 秒 化学反应动力学 阿秒 as 10⁻¹⁸ 秒 原子内部电子运动(2023 年诺贝尔物理学奖相关)
头文件:
1 | |
检查系统上是否可用HRT。
- 查看内核配置文件,其中应该包含像这样的内容:
CONFIG_HIGH_RES_TIMERS=y - 查看
cat /proc/timer_list | grep resolution的结果。.resolution项必须显示1 nsecs,事件处理程序必须显示hrtimer_interrupts。 - 使用
clock_getres系统调用。 - 在内核代码中,使用
#ifdef CONFIG_HIGH_RES_TIMERS。
在系统启用HRT的情况下,睡眠和定时器系统调用的精度不再依赖于jiffies,但它们会像HRT一样精确。这就是有些系统不支持nanosleep()之类的原因。
struct hrtimer
12345678910111213141516171819202122232425262728293031 | /** * struct hrtimer - the basic hrtimer structure * @node: timerqueue node, which also manages node.expires, * the absolute expiry time in the hrtimers internal * representation. The time is related to the clock on * which the timer is based. Is setup by adding * slack to the _softexpires value. For non range timers * identical to _softexpires. * @_softexpires: the absolute earliest expiry time of the hrtimer. * The time which was given as expiry time when the timer * was armed. * @function: timer expiry callback function * @base: pointer to the timer base (per cpu and per clock) * @state: state information (See bit values above) * @is_rel: Set if the timer was armed relative * @is_soft: Set if hrtimer will be expired in soft interrupt context. * @is_hard: Set if hrtimer will be expired in hard interrupt context * even on RT. * * The hrtimer structure must be initialized by hrtimer_init() */struct hrtimer { struct timerqueue_node node; ktime_t _softexpires; enum hrtimer_restart (*function)(struct hrtimer *); struct hrtimer_clock_base *base; u8 state; u8 is_rel; u8 is_soft; u8 is_hard;}; |
hrtimer_init()
初始化hrtimer。hrtimer初始化之前,需要设置ktime,它代表持续时间。
| 项目 | 说明 |
|---|---|
| 原型 | void hrtimer_init(struct hrtimer *timer, clockid_t which_clock, enum hrtimer_mode mode); |
| 功能 | 初始化 hrtimer |
| 参数 | timer:定时器 which_clock:时钟源 mode:模式 |
| 返回值 | 无 |
常用 clock:
- CLOCK_MONOTONIC
- CLOCK_REALTIME
常用 mode:
- HRTIMER_MODE_REL(相对时间,对于现在的时间值)
- HRTIMER_MODE_ABS(绝对时间)
hrtimer_start()
| 项目 | 说明 |
|---|---|
| 原型 | int hrtimer_start(struct hrtimer *timer, ktime_t tim, const enum hrtimer_mode mode); |
| 功能 | 启动定时器 |
| 参数 | timer:定时器 tim:时间 mode:模式 |
| 返回值 | 0 或 1 |
hrtimer_cancel()
| 项目 | 说明 |
|---|---|
| 原型 | int hrtimer_cancel(struct hrtimer *timer); |
| 功能 | 取消定时器 |
| 返回值 | 1=成功取消; 0=未运行 |
hrtimer_try_to_cancel()
| 项目 | 说明 |
|---|---|
| 函数定义 | extern int hrtimer_try_to_cancel(struct hrtimer *timer); |
| 头文件 | #include <linux/hrtimer.h> |
| 参数 timer | 要取消的struct hrtimer高精度定时器对象 |
| 功能 | 尝试取消一个高精度定时器(非阻塞方式) |
| 返回值 | >0:成功取消(定时器处于激活状态) 0:定时器未激活(已经过期或未启动) -1:定时器回调函数正在执行,无法取消 |
| 是否阻塞 | ❌ 不会等待回调执行完成(非阻塞),可在中断上下文调用 |
hrtimer_try_to_cancel 内部会调用 hrtimer_callback_running
hrtimer_callback_running()
独立检查hrtimer的回调函数是否仍在运行:
| 项目 | 说明 |
|---|---|
| 函数定义 | static inline int hrtimer_callback_running(struct hrtimer *timer); |
| 头文件 | #include <linux/hrtimer.h> |
| 参数 timer | 要检查状态的struct hrtimer高精度定时器对象 |
| 功能 | 判断该 hrtimer 的回调函数当前是否正在执行 |
| 返回值 | 若回调正在执行返回 非 0(真);否则返回 0(假) |
| 是否阻塞 | ❌ 不阻塞,仅做状态检查 |
| 使用场景 | 用于检测回调执行状态,常配合hrtimer_try_to_cancel()使用 |
12345678 | /* * Helper function to check, whether the timer is running the callback * function */static inline int hrtimer_callback_running(struct hrtimer *timer){ return timer->base->running == timer;} |
hrtimer_forward_now()
| 项目 | 说明 |
|---|---|
| 原型 | u64 hrtimer_forward_now(struct hrtimer *timer, ktime_t interval); |
| 功能 | 用于周期定时 |
| 返回值 | 转发次数 |
回调返回值
1234 | enum hrtimer_restart { HRTIMER_NORESTART, // 只执行一次 HRTIMER_RESTART, // 继续执行}; |
为了防止定时器自动重启,hrtimer回调函数必须返回HRTIMER_ NORESTART
示例
12345678910111213141516171819202122232425262728293031323334353637383940 | static struct hrtimer my_timer;static ktime_t period;static enum hrtimer_restart my_timer_callback(struct hrtimer *timer){ printk("hrtimer fired\n"); // 周期性定时 hrtimer_forward_now(timer, period); return HRTIMER_RESTART;}static int __init my_init(void){ printk("hrtimer init\n"); period = ktime_set(1, 0); // 1秒 hrtimer_init(&my_timer, CLOCK_MONOTONIC, HRTIMER_MODE_REL); my_timer.function = my_timer_callback; hrtimer_start(&my_timer, period, HRTIMER_MODE_REL); return 0;}static void __exit my_exit(void){ hrtimer_cancel(&my_timer); printk("hrtimer exit\n");}module_init(my_init);module_exit(my_exit);MODULE_LICENSE("GPL"); |
动态Tick/Tickless内核
使用之前的HZ选项,即使处于空闲状态,内核也会每秒中断HZ次以再次调度任务。如果将HZ设置为1000,则每秒会有1000次内核中断,阻止CPU长时间处于空闲状态,因此影响CPU的功耗。
现在来看一看无固定或预定义Tick的内核,这些内核中,在需要执行某些任务之前禁用Tick。这样的内核称为Tickless(无Tick)内核。
实际上,Tick 激活是依据下一个操作安排的,其正确的名字应该是动态Tick内核。内核负责系统中的任务调度,并维护可运行任务列表(运行队列)。当没有任务需要调度时,调度器切换到空闲线程,它启用动态Tick的方法是,在下一个定时器过期前(新任务排队等待处理),禁用周期性Tick。
内核内部还维护一个任务超时列表(它知道什么时候要睡眠以及睡眠多久)。
- 在空闲状态下,如果下一个Tick比任务列表超时中的最小超时更远,内核则使用该超时值对定时器进行编程。
- 当定时器到期时,内核重新启用周期Tick并调用调度器,它调度与超时相关的任务。
通过以上方式,Tickless内核移除周期性Tick,节省电量。
内核中的延迟和睡眠
延迟有两种类型,取决于代码运行的上下文:原子的或非原子的。处理内核延迟需要包含的头文件是#include <linux/delay.h>。
原子上下文
原子上下文中的任务(如ISR)不能进入睡眠状态,无法进行调度。这就是原子上下文延迟必须使用繁忙—等待循环的原因。内核提供Xdelay系列函数,在繁忙循环中消耗足够长的时间(基于jiffies),得到所需的延迟。
ndelay(unsigned long nsecs)。udelay(unsigned long usecs)。mdelay(unsigned long msecs)。
对于微秒级的短延迟推荐使用udelay(),因为ndelay()的精度取决于硬件定时器的精度(嵌入式 SOC 不一定能保证)。毫秒级的延迟应使用msleep()系列函数而非mdelay(),因为mdelay()是忙等待,会浪费 CPU 资源。
定时器处理程序(回调)在原子上下文中执行,这意味着根本不允许进入睡眠。这指的是可能导致调用程序进入睡眠的所有功能,如分配内存、锁定互斥锁、显式调用sleep()函数等
非原子上下文
在非原子上下文中,内核提供sleep[_range]系列函数,使用哪个函数取决于需要延迟多长时间。
udelay(unsigned long usecs):基于繁忙—等待循环。如果需要睡眠数微秒(小于等于10 us左右),则应该使用该函数。usleep_range(unsigned long min, unsigned long max):依赖于hrtimer,睡眠数微秒到数毫秒(10 us~20
ms)时建议使用它,避免使用udelay()的繁忙—等待循环。msleep(unsigned long msecs):由jiffies/传统定时器支持。对于数毫秒以上的长睡眠(10 ms+)请使用该函数。
内核源文档
Documentation/timers/timers-howto.rst中详细解释了睡眠和延迟相关的主题。
从内核中调用用户空间中的程序
来看下面的例子:
1234567891011121314151617181920212223242526272829303132333435363738394041424344 | static struct delayed_work initiate_shutdown_work;static void delayed_shutdown(struct work_struct *work){ char *cmd = "/sbin/shutdown"; char *argv[] = { cmd, "-h", "now", NULL, }; char *envp[] = { "HOME=/", "PATH=/sbin:/bin:/usr/sbin:/usr/bin", NULL, }; call_usermodehelper(cmd, argv, envp, 0);}static int __init my_shutdown_init( void ){ INIT_DELAYED_WORK(&delayed_shutdown, delayed_shutdown); schedule_delayed_work(&delayed_shutdown, msecs_to_jiffies(200)); return 0;}static void __exit my_shutdown_exit( void ){ return;}module_init( my_shutdown_init );module_exit( my_shutdown_exit );MODULE_LICENSE("GPL");MODULE_AUTHOR("John Madieu <john.madieu@gmail.com>");MODULE_DESCRIPTION("Simple module that trigger a delayed shut down"); |
在前面的例子中,使用的API(call_usermodehelper)是Usermode-helper API的一部分,所有函数都定义在kernel/kmod.c内。其用法非常简单。它由内核使用,例如,用于模块的加载/卸载和Cgroup管理。
IO模型
IO操作过程
一个完整的 IO 流程,通常包含以下关键环节:
- IO 调用:应用程序通过系统调用接口向内核发起 IO 请求(如读取文件)。
- IO 执行:内核收到请求之后,通过驱动程序操作硬件完成具体 IO(如从磁盘读取数据),并将最终结果返回给用户空间。
完整的 IO 过程需要包含以下三个步骤:
- 用户空间的应用程序向内核发起 IO 调用请求(系统调用)
- 内核操作系统准备数据,把 IO 设备的数据加载到内核缓冲区
- 操作系统拷贝数据,把内核缓冲区的数据拷贝到用户进程缓冲区
IO模型的分类
在实际开发中,IO 操作常常成为影响程序性能的关键因素。假设有一个场景:从磁盘读取100MB 数据并处理,读取数据耗时 20 秒,处理数据也需要 20 秒。如果采用最传统的顺序流程——读取完再处理,那么整个流程耗时约 40 秒,效率明显偏低。那么能不能在等待数据的同时对数据进行处理呢?当然可以!这时候就轮到 IO 编程模型来出场了。
在 POSIX / Linux 的定义下:IO模型有阻塞IO,非阻塞IO,信号驱动IO,IO多路复用,异步IO。其中前四个被称之为同步IO
- 同步IO
- 阻塞IO
- 非阻塞IO
- IO多路复用
- 信号驱动IO
- 异步IO
同步和异步的区别在于是否等待IO的执行结果,或者说数据拷贝到用户空间,是谁来完成的?。
同步IO:最终把数据从内核拷贝到用户空间的动作,都是由用户线程在调用
read()时完成的异步IO:
- 用户态发起 IO 请求 → 立刻返回
- 内核在后台完成 IO
- 数据已拷贝到用户空间
- 内核通知进程:IO 完成
同步阻塞IO
进程进行 IO 操作时(如 read 操作),首先会发起一个系统调用,从而转到内核空间进行处理,内核空间的数据没有准备就绪时,进程会被阻塞,不会继续向下执行,直到内核空间的数据准备完成后,数据才会从内核空间拷贝到用户空间,最后返回应用进程,由用户空间进行数据的处理。

阻塞 IO 的可以及时地获取结果,并立刻对获取到的结果进行处理,然而在获取结果之前,无法去处理其他任务,需要时刻对结果进行监听。比如C语言的scanf函数。
同步非阻塞IO
和阻塞 IO 模型不同,非阻塞 IO 进行 IO 操作时,如果内核数据没有准备好,内核会立即向进程返回 err,不会进行阻塞;如果内核空间数据准备就绪,内核会立即把数据返回给用户空间的进程。

非阻塞 IO 的优点是效率高,同样的时间内可以做别的事。但是缺点也很明显,当需要频繁检查数据就绪状态时可能导致较高的 CPU 占用率。为了解决此问题,非阻塞 IO 通常与 IO多路复用技术结合使用。
IO多路复用
select()、poll()和 epoll()函数是实现 IO 多路复用的机制。
IO 多路复用可以让单个进程监控多个描述符,当发现某个描述符就绪以后,就会通知程序进行相应的读写操作。
以 select()函数为例,如图所示。使用时需要向 select()传入待监听的文件描述符集合以及超时时间。
当执行 select()时,系统会触发一次系统调用,内核将遍历检查这些描述符是否触发了目标事件(如可读、可写)。若检测到事件则立即返回,若未检测到事件,进程将进入阻塞状态并休眠,直到任一描述符就绪或超时为止。
当 select()返回后,用户空间需遍历所有描述符,逐一确认具体是哪个触发了事件,从而实现单线程同时管理多个 IO操作的效果。

IO 多路复用的优点是一个进程/线程可以同时监听和处理多路 IO,效率成倍提高。但是 IO多路复用并不是能医治百病的良药,虽然 IO 多路复用可以监听多个 IO,但是实际上对结果的处理也只能依次进行,比较适合 IO 密集但是每一路 IO 数据量不多且到达时间分散的场合(如网络聊天)。
另外 select 监听的描述符有上限(一般描述符最大不超过 1024),而且需要遍历究竟是哪一个 IO 产生了数据。因此 IO 较多时,效率不高(这个问题被 epoll 解决)。
信号驱动IO
信号驱动 IO 指的是进程会预先告知内核,当某个描述符发生事件时,内核要向该进程发送 SIGIO 信号进行通知,进程可以在信号处理函数中对该事件进行处理。
例如在 Linux 系统中,用户按下 ctrl+C 终止运行中的任务时,系统实际上是对该进程发送一个 SIGINT 信号,该信号的默认处理函数就是退出当前程序。
具体到 IO 模型上,进程需要先为 SIGIO 信号注册相应的信号处理函数,并打开对应描述符的信号驱动。当数据准备好时,进程会收到一个 SIGIO 信号,可以在信号处理函数中调用 IO操作函数处理数据。

异步IO
aio_read()函数常常用于异步 IO,当进程使用aio_read()读取数据时,如果数据尚未准备就绪就立即返回,不会阻塞。
若数据准备就绪就会把数据从内核空间拷贝到用户空间的缓冲区中,然后执行定义好的回调函数对接收到的数据进行处理。

但是对于Linux AIO,Linux AIO 只支持 direct I/O 模式的存储文件 (storage file),而且主要用在数据库这一细分领域;
而io_uring支持存储文件和网络文件(network sockets),也支持更多的异步系统调用 (accept/openat/stat/...),而非仅限于read/write系统调用。
等待队列实现阻塞IO
在 Linux 驱动程序中,阻塞进程可以使用等待队列来实现。
步骤一:初始化等待队列头,并将条件置成假(condition=0)。
步骤二:在需要阻塞的地方调用wait_event(),使进程进入休眠状态
步骤三:当条件满足时,需要解除休眠,先将条件(condition=1),然后调用wake_up()函数唤醒等待队列中的休眠进程。
驱动:
123456789101112131415161718192021222324252627282930313233343536373839404142434445464748495051525354555657585960616263646566676869707172737475767778798081828384858687888990919293949596979899100101102103104105106107108109110111112113114115116117118119120121122123124125126127128129130131132133134135136137138139140141142143144145146147148149150151152153 | struct waitqueue_drv_data { dev_t dev_num; struct cdev cdev; struct class *class; struct device *dev; char kbuf[KBUF_CAPACITY]; bool kbuf_ready; wait_queue_head_t waitque;};static struct waitqueue_drv_data *drv_dat;// DECLARE_WAIT_QUEUE_HEAD(waitque);int waitqueue_test_open(struct inode *inode, struct file *file){ file->private_data = drv_dat; pr_info("waitqueue_test_open is called\n"); return 0;}ssize_t waitqueue_test_read(struct file *file, char __user *buf, size_t size, loff_t *offset){ struct waitqueue_drv_data *dat = file->private_data; size_t len; int ret; // 如果以非阻塞方式打开 if (file->f_flags & O_NONBLOCK) { if (!dat->kbuf_ready) return -EAGAIN; } else { // 以阻塞方式打开 ret = wait_event_interruptible(dat->waitque, dat->kbuf_ready == true); if (ret < 0) { pr_err("waitque_test_read is interrupted\n"); return ret; } } len = min(size, (size_t)strlen(dat->kbuf)); if (copy_to_user(buf, dat->kbuf + *offset, len) != 0) return -EFAULT; dat->kbuf_ready = false; return len;}ssize_t waitqueue_test_write(struct file *file, const char __user *buf, size_t size, loff_t *offset){ struct waitqueue_drv_data *dat = file->private_data; size_t len = min(size, (size_t)(KBUF_CAPACITY - 1)); if (copy_from_user(dat->kbuf, buf, len) != 0) return -EFAULT; dat->kbuf[len] = '\0'; dat->kbuf_ready = true; wake_up_interruptible(&dat->waitque); return len;}int waitqueue_test_release(struct inode *inode, struct file *file){ pr_info("waitqueue_test_release is called\n"); return 0;}static struct file_operations fops = { .owner = THIS_MODULE, .open = waitqueue_test_open, .read = waitqueue_test_read, .write = waitqueue_test_write, .release = waitqueue_test_release,};static int __init waitqueue_test_init(void){ int err; drv_dat = (struct waitqueue_drv_data *)kzalloc(sizeof(struct waitqueue_drv_data), GFP_KERNEL); if (drv_dat == NULL) goto kzalloc_fail; err = alloc_chrdev_region(&drv_dat->dev_num, 0, 1, "waitque_drv_chrdev_region"); if (err < 0) goto alloc_chrdev_region_fail; cdev_init(&drv_dat->cdev, &fops); drv_dat->cdev.owner = THIS_MODULE; err = cdev_add(&drv_dat->cdev, drv_dat->dev_num, 1); if (err < 0) goto cdev_add_fail; drv_dat->class = class_create(THIS_MODULE, "chrdev"); if (IS_ERR(drv_dat->class)) { err = PTR_ERR(drv_dat->class); goto class_create_fail; } drv_dat->dev = device_create(drv_dat->class, NULL, drv_dat->dev_num, NULL, "waitqueue_test%d", 0); if (IS_ERR(drv_dat->dev)) { err = PTR_ERR(drv_dat->dev); goto device_create_fail; } // 初始化等待队列 init_waitqueue_head(&drv_dat->waitque); return 0;device_create_fail: class_destroy(drv_dat->class);class_create_fail: cdev_del(&drv_dat->cdev);cdev_add_fail: unregister_chrdev_region(drv_dat->dev_num, 1);alloc_chrdev_region_fail: kfree(drv_dat);kzalloc_fail: return err;}static void __exit waitqueue_test_exit(void){ device_destroy(drv_dat->class, drv_dat->dev_num); class_destroy(drv_dat->class); cdev_del(&drv_dat->cdev); unregister_chrdev_region(drv_dat->dev_num, 1); kfree(drv_dat);}module_init(waitqueue_test_init);module_exit(waitqueue_test_exit);MODULE_LICENSE("GPL");MODULE_AUTHOR("even629<asqwgo@163.com>");MODULE_DESCRIPTION("waitqueue sample"); |
测试
1234567891011121314 | $ cat /dev/waitqueue_test0 &[ 18.186918] waitqueue_test_open is called$ echo "Hello World" > /dev/waitqueue_test0[ 33.059018] waitqueue_test_open is called[ 33.060401] waitqueue_test_release is calledHello World$ echo "Hello Linux" > /dev/waitqueue_test0[ 43.618554] waitqueue_test_open is called[ 43.619516] waitqueue_test_release is calledHello Linux |
非阻塞式访问
应用程序可以使用如下所示示例代码来实现阻塞访问:
12345 | int fd;int data = 0;fd = open("/dev/xxx_dev", O_RDWR);/* 阻塞方式打开 */ret = read(fd, &data, sizeof(data));/* 读取数据 */ |
可以看出对于设备驱动文件的默认读取方式就是阻塞式的,所以之前实验例程测试都是采用阻塞 IO。如果应用程序要采用非阻塞的方式来访问驱动设备文件,可以使用如下所示代码:
1234 | int fd;int data = 0;fd = open("/dev/xxx_dev", O_RDWR | O_NONBLOCK); /*非阻塞方式打开 */ret = read(fd, &data, sizeof(data)); /* 读取数据 */ |
使用 open 函数打开“/dev/xxx_dev”设备文件的时候添加了参数“O_NONBLOCK”,表示以非阻塞方式打开设备,这样从设备中读取数据的时候是非阻塞方式了。
驱动程序
通过file结构体中的f_flags中查询应用程序是否通过O_NONBLOCK方式打开
12345678 | static ssize_t cdev_test_read(struct file *file, char __user *buf, size_t size, loff_t *off){ struct device_test *test_dev=(struct device_test *)file->private_data; if(file->f_flags & O_NONBLOCK ){ if (test_dev->flag !=1) return -EAGAIN; } ... |
IO多路复用的实现
IO 多路复用是一种同步的 IO 模型。IO 多路复用可以实现一个进程监视多个文件描述符。一旦某个文件描述符准备就绪,就通知应用程序进行相应的读写操作。没有文件描述符就绪时就会阻塞应用程序,从而释放出 CPU 资源。
在应用层 Linux 提供了三种实现 IO 多路复用的模型,分别是 select、poll 和 epoll。
- poll和select基本一样,都可以监听多个文件描述符,通过轮询文件描述符来获取已经准备好的文件描述符
- epoll是将主动轮询变成了被动通知,当事件发生时,被动地接收通知。
Linux 应用层 poll
| 项目 | 内容 |
|---|---|
| 作用 | 监视多个文件描述符的读写事件或异常事件 |
| 原型 | int poll(struct pollfd *fds, nfds_t nfds, int timeout); |
| 参数 | -fds:struct pollfd 数组,描述被监视的文件描述符及事件 - nfds:被监视的 fd 数量- timeout:超时时间(ms)>0:等待指定时间; = 0:立即返回; -1:永远阻塞,直到事件发生 |
| 返回值 | >0:返回 revents ≠ 0 的 fd 数量 =0:超时 -1:失败 |
struct pollfd
12345 | struct pollfd { int fd; // 被监视的文件描述符 short events; // 需要监视的事件 short revents; // 内核返回的事件}; |
pollfd的events和revents
| 事件类型 | 常值 | 作为 events 的值 | 作为 revents 的值 | 说明 |
|---|---|---|---|---|
| 读事件 | POLLIN | ✔ | ✔ | 有普通数据可读 |
| 读事件 | POLLRDNORM | ✔ | ✔ | 可读(常规数据) |
| 读事件 | POLLRDBAND | ✔ | ✔ | 可读(带外数据) |
| 读事件 | POLLPRI | ✔ | ✔ | 可读(高优先级数据) |
| 写事件 | POLLOUT | ✔ | ✔ | 可写 |
| 写事件 | POLLWRNORM | ✔ | ✔ | 可写(常规数据) |
| 写事件 | POLLWRBAND | ✔ | ✔ | 可写(带外数据) |
| 错误事件 | POLLERR | ✔ | 发生错误 | |
| 错误事件 | POLLHUP | ✔ | 发生挂起 | |
| 错误事件 | POLLNVAL | ✔ | 描述符不是打开的文件 |
驱动层 poll
| 项目 | 内容 |
|---|---|
| 原型 | unsigned int (*poll)(struct file *filp, struct poll_table_struct *wait); |
| 作用 | 告诉内核:当前设备是否可 non-blocking 访问(可读/可写) |
| 参数 | -filp:文件结构体指针 - wait:内核传入的 poll_table,用于登记等待队列 |
| 返回值 | 返回状态位掩码(同 POLLIN/POLLOUT 等事件) |
如果需要实现被动等待(在感知字符设备时不浪费CPU周期),则必须实现poll()函数,每当用户空间程序在与设备关联的文件上执行系统调用select()或poll()时都会调用poll()函数。
这个方法核心的内核函数是poll_wait(),它定义在<linux/poll.h>中,这个头文件应该包含在驱动代码中。
驱动中的实现
poll_wait()
| 项目 | 内容 |
|---|---|
| 作用 | 把驱动中的等待队列加入到 poll_table 中,用于 select/poll/epoll |
| 原型 | void poll_wait(struct file *filp, wait_queue_head_t *queue, poll_table *wait); |
| 头文件 | #include <linux/poll.h> |
| 参数 | -filp:文件 - queue:等待队列头(wait_queue_head_t) - wait:poll_table(来自应用层) |
| 返回值 | 无 |
| 特点 | 不会阻塞! 只是登记等待队列 |
poll_wait()根据注册到struct poll_table结构(作为第三个参数传递)中的事件,把与struct filep结构(作为第一个参数)关联的设备添加到可以唤醒进程的列表(由第二个参数struct wait_queue_head_t结构指定,进程在其中处于睡眠状态)中。
用户进程可以运行poll()、select()或者epoll()系统调用把需要等待的一组文件添加到等待队列上,以了解是否有相关的设备准备就绪。
之后,内核将会调用与每个设备文件相关的驱动程序的poll入口。每个驱动程序的poll方法再调用poll_wait,为需要接收内核通知的进程注册事件,在这些事件发生之前把进程置于睡眠状态,并把驱动程序注册为可以唤醒进程的驱动程序。
步骤
- 为每个需要实现被动等待的事件类型(读、写、异常)声明等待队列,当无数据可读或设备不可写时,把任务放入该队列:
12 | static DECLARE_WAIT_QUEUE_HEAD(my_wq);static DECLARE_WAIT_QUEUE_HEAD(my_rq); |
- 像这样实现poll函数
12345678910111213 | static unsigned int eep_poll(struct file *file, poll_table *wait){ unsigned int reval_mask = 0; poll_wait(file, &my_wq, wait); poll_wait(file, &my_rq, wait); if (new-data-is-ready) reval_mask |= (POLLIN | POLLRDNORM); if (ready_to_be_written) reval_mask |= (POLLOUT | POLLWRNORM); return reval_mask;} |
- 当有新数据或者是设备可写入时,通知等待队列:
12 | wake_up_interruptible(&my_rq); /* 准备读取 */wake_up_interruptible(&my_wq); /* 准备写入 */ |
通知可读事件可以采用以下两种方法:
- 在驱动程序的write()方法中通知,这意味着写入的数据可以读回;
- 在IRQ处理程序中通知,这意味着外部设备发送的数据可以读回。
通知可写事件可以采用以下两种方法:
- 在驱动程序的read()方法中通知,这意味着缓冲区是空的,可以被重新填充;
- 在IRQ处理程序中通知,这意味着设备已经完成数据发送,准备好再次接收数据。
示例
app read.c
123456789101112131415161718192021222324252627282930313233343536373839404142434445464748495051525354555657585960616263646566676869707172737475767778798081828384858687888990919293 | int main(int argc, char **argv){ pid_t pid; int fd, ret; char prefix[32]; int ops_nr = 10; pid = fork(); if (pid < 0) { perror("[fork error]"); exit(EXIT_FAILURE); } else if (pid == 0) { //child char buf[32]; int i; sprintf(prefix, "[child, pid:%d]:", getpid()); fd = open("/dev/poll_test0", O_RDWR); if (fd < 0) { fprintf(stderr, "%s Error: %s(errno:%d)\n", prefix, strerror(errno), errno); exit(EXIT_FAILURE); } // child write for about 10 secs for (i = 0; i < ops_nr; i++) { sprintf(buf, "%d", i); ret = write(fd, buf, strlen(buf) + 1); if (ret < 0) { close(fd); fprintf(stderr, "%s Error: %s(errno:%d)\n", prefix, strerror(errno), errno); exit(EXIT_FAILURE); } sleep(1); } close(fd); } else { // parent char buf[32]; struct pollfd poll_fds[1]; sprintf(prefix, "[parent, pid:%d]:", getpid()); fd = open("/dev/poll_test0", O_RDWR); if (fd < 0) { fprintf(stderr, "%s Error: %s(errno:%d)\n", prefix, strerror(errno), errno); exit(EXIT_FAILURE); } poll_fds[0].fd = fd; poll_fds[0].events = POLLIN; for (;;) { ret = poll(poll_fds, sizeof(poll_fds) / sizeof(struct pollfd), 3000); if (ret == 0) { printf("timeout\n"); } else if (ret < 0) { close(fd); fprintf(stderr, "%s Error: %s(errno:%d)\n", prefix, strerror(errno), errno); exit(EXIT_FAILURE); } else { if (poll_fds[0].revents & POLLIN) { ret = read(fd, buf, sizeof(buf)); if (ret < 0) { close(fd); fprintf(stderr, "%s Error: %s(errno:%d)\n", prefix, strerror(errno), errno); exit(EXIT_FAILURE); } printf("%s read: %s, read ret: %d\n", prefix, buf, ret); ops_nr--; if (ops_nr == 0) { break; } } else { printf("%s poll_fds[0].revents is %d\n", prefix, poll_fds[0].revents); } } } close(fd); } return 0;} |
驱动程序
123456789101112131415161718192021222324252627282930313233343536373839404142434445464748495051525354555657585960616263646566676869707172737475767778798081828384858687888990919293949596979899100101102103104105106107108109110111112113114115116117118119120121122123124125126127128129130131132133134135136137138139140141142143144145146147148149150151152153154155156157158159160161162163164165166167168169170171172173174175176177178179180181182183184185186187188189190191192193194195196197198199200 | struct poll_test_drv_data { dev_t dev_num; struct cdev cdev; struct class *class; struct device *dev; char kbuf[KBUF_SIZE]; wait_queue_head_t waitque; struct mutex lock;};static struct poll_test_drv_data *drv_dat;int poll_test_open(struct inode *inode, struct file *file){ file->private_data = drv_dat; pr_info("open is called by pid: %d\n", current->pid); return 0;}ssize_t poll_test_read(struct file *file, char __user *buf, size_t size, loff_t *offset){ int ret; size_t len; struct poll_test_drv_data *dat = file->private_data; pr_info("read is called by pid: %d\n", current->pid); if (file->f_flags & O_NONBLOCK) { mutex_lock(&dat->lock); if (dat->kbuf[0] == '\0') { mutex_unlock(&dat->lock); return -EAGAIN; } mutex_unlock(&dat->lock); } else { /* wait_event 条件必须“可重入、可重复检查” */ ret = wait_event_interruptible(dat->waitque, ({ int ready; mutex_lock(&dat->lock); ready = (dat->kbuf[0] != '\0'); mutex_unlock(&dat->lock); ready; })); if (ret < 0) { pr_info("pid: %d read is interrupted while waiting\n", current->pid); return ret; } } mutex_lock(&dat->lock); len = min(size, strlen(dat->kbuf) + 1); if (copy_to_user(buf, dat->kbuf, len)) { mutex_unlock(&dat->lock); return -EFAULT; } dat->kbuf[0] = '\0'; // reset kbuf string mutex_unlock(&dat->lock); return len;}ssize_t poll_test_write(struct file *file, const char __user *buf, size_t size, loff_t *offset){ size_t len; struct poll_test_drv_data *dat = file->private_data; pr_info("write is called by pid: %d\n", current->pid); len = min(size, (size_t)(KBUF_SIZE - 1)); mutex_lock(&dat->lock); if (copy_from_user(dat->kbuf, buf, len)) { mutex_unlock(&dat->lock); return -EFAULT; } dat->kbuf[len] = '\0'; // make sure kbuf a valid string(end with '\0') mutex_unlock(&dat->lock); /* 在解锁后唤醒 */ wake_up_interruptible(&dat->waitque); return len;}__poll_t poll_test_poll(struct file *file, struct poll_table_struct *p){ struct poll_test_drv_data *dat = file->private_data; __poll_t mask = 0; pr_info("poll is called by pid: %d\n", current->pid); poll_wait(file, &dat->waitque, p); mutex_lock(&dat->lock); if (dat->kbuf[0] != '\0') mask |= POLLIN | POLLRDNORM; mutex_unlock(&dat->lock); return mask;}int poll_test_release(struct inode *inode, struct file *file){ pr_info("release is called by pid: %d\n", current->pid); return 0;}static struct file_operations fops = { .owner = THIS_MODULE, .open = poll_test_open, .read = poll_test_read, .write = poll_test_write, .poll = poll_test_poll, .release = poll_test_release,};static int __init poll_test_init(void){ int ret; drv_dat = (struct poll_test_drv_data *)kzalloc(sizeof(struct poll_test_drv_data), GFP_KERNEL); if (drv_dat == NULL) { ret = -ENOMEM; goto kzalloc_fail; } ret = alloc_chrdev_region(&drv_dat->dev_num, 0, 1, "test_chrdev_region"); if (ret < 0) goto alloc_chrdev_region_fail; cdev_init(&drv_dat->cdev, &fops); drv_dat->cdev.owner = THIS_MODULE; ret = cdev_add(&drv_dat->cdev, drv_dat->dev_num, 1); if (ret < 0) goto cdev_add_fail; drv_dat->class = class_create(THIS_MODULE, "chrdev"); if (IS_ERR(drv_dat->class)) { ret = PTR_ERR(drv_dat->class); goto class_create_fail; } drv_dat->dev = device_create(drv_dat->class, NULL, drv_dat->dev_num, NULL, "poll_test%d", 0); if (IS_ERR(drv_dat->dev)) { ret = PTR_ERR(drv_dat->dev); goto device_create_fail; } drv_dat->kbuf[0] = '\0'; // always keep kbuf a valid string mutex_init(&drv_dat->lock); // 初始化等待队列 init_waitqueue_head(&drv_dat->waitque); return 0;device_create_fail: class_destroy(drv_dat->class);class_create_fail: cdev_del(&drv_dat->cdev);cdev_add_fail: unregister_chrdev_region(drv_dat->dev_num, 1);alloc_chrdev_region_fail: kfree(drv_dat);kzalloc_fail: return ret;}static void __exit poll_test_exit(void){ device_destroy(drv_dat->class, drv_dat->dev_num); class_destroy(drv_dat->class); cdev_del(&drv_dat->cdev); unregister_chrdev_region(drv_dat->dev_num, 1); kfree(drv_dat);}module_init(poll_test_init);module_exit(poll_test_exit);MODULE_LICENSE("GPL");MODULE_AUTHOR("even629<asqwgo@163.com>");MODULE_DESCRIPTION("This is a test sample for poll_test"); |
测试:
1234567891011121314151617181920212223242526272829303132333435363738394041424344454647484950515253545556 | $ insmod poll_test.ko[ 12.171314] poll_test: loading out-of-tree module taints kernel.$ ./test_poll.o[ 15.908771] open is called by pid: 101[ 15.908795] open is called by pid: 102[ 15.909346] write is called by pid: 102[ 15.909902] poll is called by pid: 101[ 15.910627] read is called by pid: 101[parent, pid:101]: read: 0, read ret: 2[ 15.915991] poll is called by pid: 101[ 16.914086] write is called by pid: 102[ 16.917324] poll is called by pid: 101[ 16.917645] read is called by pid: 101[parent, pid:101]: read: 1, read ret: 2[ 16.918526] poll is called by pid: 101[ 17.917861] write is called by pid: 102[ 17.919219] poll is called by pid: 101[ 17.919745] read is called by pid: 101[parent, pid:101]: read: 2, read ret: 2[ 17.922355] poll is called by pid: 101[ 18.920467] write is called by pid: 102[ 18.921819] poll is called by pid: 101[ 18.923714] read is called by pid: 101[parent, pid:101]: read: 3, read ret: 2[ 18.924807] poll is called by pid: 101[ 19.923667] write is called by pid: 102[ 19.925368] poll is called by pid: 101[ 19.926362] read is called by pid: 101[parent, pid:101]: read: 4, read ret: 2[ 19.927909] poll is called by pid: 101[ 20.926284] write is called by pid: 102[ 20.927049] poll is called by pid: 101[ 20.927249] read is called by pid: 101[parent, pid:101]: read: 5, read ret: 2[ 20.927689] poll is called by pid: 101[ 21.927490] write is called by pid: 102[ 21.928342] poll is called by pid: 101[ 21.928747] read is called by pid: 101[parent, pid:101]: read: 6, read ret: 2[ 21.929097] poll is called by pid: 101[ 22.929789] write is called by pid: 102[ 22.931600] poll is called by pid: 101[ 22.932469] read is called by pid: 101[parent, pid:101]: read: 7, read ret: 2[ 22.934791] poll is called by pid: 101[ 23.932151] write is called by pid: 102[ 23.933917] poll is called by pid: 101[ 23.936726] read is called by pid: 101[parent, pid:101]: read: 8, read ret: 2[ 23.938596] poll is called by pid: 101[ 24.933805] write is called by pid: 102[ 24.935854] poll is called by pid: 101[ 24.936546] read is called by pid: 101[parent, pid:101]: read: 9, read ret: 2[ 24.937991] release is called by pid: 101[ 25.937143] release is called by pid: 102 |
信号驱动IO
信号驱动 IO 不需要应用程序查询设备的状态,一旦设备准备就绪,会触发 SIGIO 信号,进而调用注册的处理函数。
如果要实现信号驱动 IO,需要应用程序和驱动程序配合,应用程序使用信号驱动 IO 的步骤有三步:
- 步骤 1 :注册信号处理函数 应用程序使用 signal 函数来注册 SIGIO 信号的信号处理函数。
- 步骤 2: 设置能够接收这个信号的进程(fcntl函数)
- 步骤 3: 开启信号驱动 IO 通常使用 fcntl 函数的 F_SETFL 命令打开 FASYNC 标志。
用户态可以用O_ASYNC也可以用FASYNC
驱动实现
当应用程序开启信号驱动 IO 时,会触发驱动中的 fasync 函数。所以首先在 file_operations结构体中实现 fasync 函数,函数原型如下:
1 | int (*fasync) (int fd,struct file *filp,int on) |
在驱动中的 fasync 函数调用 fasync_helper 函数来操作 fasync_struct 结构体,fasync_helper函数原型如下:
1 | int fasync_helper(int fd,struct file *filp,int on,struct fasync_struct **fapp) |
其中struct fasync_struct定义如下:
12345678 | struct fasync_struct { rwlock_t fa_lock; int magic; int fa_fd; struct fasync_struct *fa_next; /* singly linked list */ struct file *fa_file; struct rcu_head fa_rcu;}; |
struct fasync_struct是内核用来管理「哪些进程希望对某个 file 收到 SIGIO / SIGURG 信号」的链表节点。
每一个
fasync_struct= 一个订阅者驱动里保存的是 链表头指针
kill_fasync()遍历这条链表发信号
当设备准备好的时候,驱动程序需要调用 kill_fasync 函数通知应用程序,此时应用程序的SIGIO 信号处理函数就会被执行。kill_fasync 负责发送指定的信号,函数原型如下:
1 | void kill_fasync(struct fasync_struct **fp,int sig,int band) |
- 函数参数:
- fp: 要操作的
fasync_struct - sig: 发送的信号
- band: 可读的时候设置成 POLLIN ,可写的时候设置成 POLLOUT
- fp: 要操作的
示例
app
123456789101112131415161718192021222324252627282930313233343536373839404142434445464748495051525354555657585960616263646566676869707172737475767778798081828384858687888990 | static int fd;static char buf[32];static char prefix[32];static volatile sig_atomic_t data_ready = 0;void handle_sigio(int sig){ data_ready = 1;}int main(int argc, char **argv){ pid_t pid; int ret; pid = fork(); if (pid < 0) { perror("[fork error]"); exit(EXIT_FAILURE); } else if (pid == 0) { // child write int i; sprintf(prefix, "[child pid:%d]", getpid()); fd = open("/dev/signal_io_test0", O_RDWR); if (fd < 0) { perror(prefix); exit(EXIT_FAILURE); } for (i = 0; i < INT_MAX; i++) { sprintf(buf, "Hello num %d", i); ret = write(fd, buf, strlen(buf) + 1); if (ret < 0) { perror(prefix); close(fd); exit(EXIT_FAILURE); } printf("%s: write: %s\n", prefix, buf); sleep(1); } close(fd); } else { // parent read by signal int flags; sprintf(prefix, "[parent pid:%d]", getpid()); fd = open("/dev/signal_io_test0", O_RDWR); if (fd < 0) { perror(prefix); exit(EXIT_FAILURE); } sprintf(prefix, "[parent pid:%d]", getpid()); // 1. 注册SIGIO信号的信号处理函数 // signal(SIGIO, handle_sigio); // better not use signal // use sigaction instead struct sigaction act; act.sa_handler = handle_sigio; sigemptyset(&act.sa_mask); //当这个信号处理函数正在执行时,哪些信号要被“暂时屏蔽” act.sa_flags = 0; // 不启用任何特殊行为 sigaction(SIGIO, &act, NULL); // 2. 设置能接收这个信号的进程 fcntl(fd, F_SETOWN, getpid()); // 3. 开启信号驱动io flags = fcntl(fd, F_GETFL); fcntl(fd, F_SETFL, flags | O_ASYNC); for (;;) { pause(); // wait for signal if (data_ready) { data_ready = 0; ret = read(fd, buf, sizeof(buf)); printf("%s: read: %s\n", prefix, buf); } } close(fd); } return 0;} |
驱动程序
123456789101112131415161718192021222324252627282930313233343536373839404142434445464748495051525354555657585960616263646566676869707172737475767778798081828384858687888990919293949596979899100101102103104105106107108109110111112113114115116117118119120121122123124125126127128129130131132133134135136137138139140141142143144145146147148149150151152153154155156157158159160161162163164165166167168169170171172173174175176177178179180181182183184185186187188189190191192193194195196197198199200201202203204205206207208 | struct drv_data { dev_t dev_num; struct cdev cdev; struct class *class; struct device *dev; wait_queue_head_t waitq; char kbuf[KBUF_SIZE]; struct mutex lock; struct fasync_struct *fa;};static struct drv_data *drv_dat;int signal_io_open(struct inode *inode, struct file *file){ file->private_data = drv_dat; pr_info("signal_io_open is called by pid: %d\n", task_pid_nr(current)); return 0;}ssize_t signal_io_read(struct file *file, char __user *buf, size_t size, loff_t *offset){ struct drv_data *dat = file->private_data; size_t len; int ret; if (file->f_flags & O_NONBLOCK) { // 非阻塞方式 mutex_lock(&drv_dat->lock); if (dat->kbuf[0] == '\0') { mutex_unlock(&drv_dat->lock); return -EAGAIN; } mutex_unlock(&drv_dat->lock); } else { // 阻塞方式 ret = wait_event_interruptible(drv_dat->waitq, ({ bool status; mutex_lock(&drv_dat->lock); status = (dat->kbuf[0] != '\0'); mutex_unlock(&drv_dat->lock); status; })); if(ret < 0){ pr_info("signal_io_read called by pid: %d is interrupted\n", task_pid_nr(current)); return ret; } } mutex_lock(&dat->lock); len = min(size, strlen(dat->kbuf) + 1); if (copy_to_user(buf, dat->kbuf, len) != 0) { mutex_unlock(&dat->lock); return -EFAULT; } dat->kbuf[0] = '\0'; // clear kbuf mutex_unlock(&dat->lock); pr_info("signal_io_read is called by pid: %d\n", task_pid_nr(current)); return len;}ssize_t signal_io_write(struct file *file, const char __user *buf, size_t size, loff_t *offset){ struct drv_data *dat = file->private_data; int len = min(size, (size_t)(KBUF_SIZE - 1)); mutex_lock(&dat->lock); if (copy_from_user(drv_dat->kbuf, buf, len) != 0) { mutex_unlock(&dat->lock); return -EFAULT; } dat->kbuf[len] = '\0'; mutex_unlock(&dat->lock); wake_up_interruptible(&dat->waitq); kill_fasync(&dat->fa, SIGIO, POLLIN); pr_info("signal_io_write is called by pid: %d\n", task_pid_nr(current)); return len;}__poll_t signal_io_poll(struct file *file, struct poll_table_struct *p){ struct drv_data *dat = file->private_data; __poll_t mask = 0; pr_info("signal_io_poll is called by pid: %d\n", task_pid_nr(current)); poll_wait(file, &dat->waitq, p); mutex_lock(&dat->lock); if (dat->kbuf[0] != '\0') { mask |= POLLIN | POLLRDNORM; } mutex_unlock(&dat->lock); return mask;}int signal_io_fasync(int fd, struct file *file, int on){ struct drv_data *dat = file->private_data; pr_info("signal_io_fasync is called by pid: %d\n", task_pid_nr(current)); return fasync_helper(fd, file, on, &dat->fa);}int signal_io_release(struct inode *inode, struct file *file){ pr_info("signal_io_release is called by pid: %d\n", task_pid_nr(current)); /* 强制从异步队列移除 */ signal_io_fasync(-1, file, 0); return 0;}struct file_operations fops = { .owner = THIS_MODULE, .open = signal_io_open, .read = signal_io_read, .write = signal_io_write, .poll = signal_io_poll, .fasync = signal_io_fasync, .release = signal_io_release,};static int __init signal_io_init(void){ int ret; drv_dat = (struct drv_data *)kzalloc(sizeof(struct drv_data), GFP_KERNEL); if (drv_dat == NULL) { ret = -ENOMEM; goto kzalloc_fail; } ret = alloc_chrdev_region(&drv_dat->dev_num, 0, 1, "chrdev_test_region"); if (ret < 0) goto alloc_chrdev_region_fail; cdev_init(&drv_dat->cdev, &fops); drv_dat->cdev.owner = THIS_MODULE; ret = cdev_add(&drv_dat->cdev, drv_dat->dev_num, 1); if (ret < 0) goto cdev_add_fail; drv_dat->class = class_create(THIS_MODULE, "chrdev_test"); if (IS_ERR(drv_dat->class)) { ret = PTR_ERR(drv_dat->class); goto class_create_fail; } drv_dat->dev = device_create(drv_dat->class, NULL, drv_dat->dev_num, NULL, "signal_io_test%d", 0); if (IS_ERR(drv_dat->dev)) { ret = PTR_ERR(drv_dat->dev); goto device_create_fail; } drv_dat->kbuf[0] = '\0'; // 初始化等待队列 init_waitqueue_head(&drv_dat->waitq); // 初始化互斥锁 mutex_init(&drv_dat->lock); return 0;device_create_fail: class_destroy(drv_dat->class);class_create_fail: cdev_del(&drv_dat->cdev);cdev_add_fail: unregister_chrdev_region(drv_dat->dev_num, 1);alloc_chrdev_region_fail: kfree(drv_dat);kzalloc_fail: return ret;}static void __exit signal_io_exit(void){ device_destroy(drv_dat->class, drv_dat->dev_num); class_destroy(drv_dat->class); cdev_del(&drv_dat->cdev); unregister_chrdev_region(drv_dat->dev_num, 1); kfree(drv_dat);}module_init(signal_io_init);module_exit(signal_io_exit);MODULE_LICENSE("GPL");MODULE_AUTHOR("even629<asqwgo@163.com>");MODULE_DESCRIPTION("test sample for signal io"); |
测试:
123456789101112131415161718192021222324252627282930313233343536373839404142434445464748495051525354555657585960616263646566 | $ insmod signal_io.ko[ 13.310579] signal_io: loading out-of-tree module taints kernel.$ ./test_signal.o[ 16.052738] signal_io_open is called by pid: 102[ 16.052761] signal_io_open is called by pid: 101[ 16.053719] signal_io_write is called by pid: 102[ 16.053816] signal_io_fasync is called by pid: 101[child pid:102]: write: Hello num 0[ 17.062149] signal_io_write is called by pid: 102[child pid:102]: write: Hello num 1[ 17.063588] signal_io_read is called by pid: 101[parent pid:101]: read: Hello num 1[ 18.066214] signal_io_write is called by pid: 102[ 18.068176] signal_io_read is called by pid: 101[child pid:102]: write: Hello num 2[parent pid:101]: read: Hello num 2[ 19.072969] signal_io_write is called by pid: 102[child pid:102]: write: Hello num 3[ 19.078051] signal_io_read is called by pid: 101[parent pid:101]: read: Hello num 3[ 20.078613] signal_io_write is called by pid: 102[ 20.079554] signal_io_read is called by pid: 101[child pid:102]: write: Hello num 4[parent pid:101]: read: Hello num 4[ 21.081299] signal_io_write is called by pid: 102[child pid:102]: write: Hello num 5[ 21.082047] signal_io_read is called by pid: 101[parent pid:101]: read: Hello num 5[ 22.082641] signal_io_write is called by pid: 102[child pid:102]: write: Hello num 6[ 22.083896] signal_io_read is called by pid: 101[parent pid:101]: read: Hello num 6[ 23.085311] signal_io_write is called by pid: 102[child pid:102]: write: Hello num 7[ 23.086379] signal_io_read is called by pid: 101[parent pid:101]: read: Hello num 7[ 24.088591] signal_io_write is called by pid: 102[child pid:102]: write: Hello num 8[ 24.091260] signal_io_read is called by pid: 101[parent pid:101]: read: Hello num 8[ 25.094550] signal_io_write is called by pid: 102[ 25.095438] signal_io_read is called by pid: 101[child pid:102]: write: Hello num 9[parent pid:101]: read: Hello num 9[ 26.098043] signal_io_write is called by pid: 102[ 26.100002] signal_io_read is called by pid: 101[child pid:102]: write: Hello num 10[parent pid:101]: read: Hello num 10[ 27.103532] signal_io_write is called by pid: 102[child pid:102]: write: Hello num 11[ 27.105751] signal_io_read is called by pid: 101[parent pid:101]: read: Hello num 11[ 28.112041] signal_io_write is called by pid: 102[child pid:102]: write: Hello num 12[ 28.114740] signal_io_read is called by pid: 101[parent pid:101]: read: Hello num 12[ 29.118790] signal_io_write is called by pid: 102[ 29.121123] signal_io_read is called by pid: 101[child pid:102]: write: Hello num 13[parent pid:101]: read: Hello num 13^C[ 29.356357] signal_io_fasync is called by pid: 101[ 29.356383] signal_io_release is called by pid: 102[ 29.356413] signal_io_fasync is called by pid: 102[ 29.356999] signal_io_release is called by pid: 101[ 29.357737] signal_io_fasync is called by pid: 101 |
异步IO
异步IO依赖于应用层glibc中的实现,可以不依赖Linux内核
参考:

对于io_uring可以参考本站这篇文章
Linux内核打印
dmesg
终端使用 dmesg 命令可以获取内核打印信息,该命令的具体使用方法如下所示:
dmesg 命令
- 英文全称:display message(显示信息)
- 作用:kernel 会将打印信息存储在 ring buffer 中。可以利用 dmesg 命令来查看内核打印信息
- 常用参数:
- -C,–clear 清除内核环形缓冲区
- -c,—-read-clear 读取并清除所有消息
- -T,–显示时间戳
dmesg 命令也可以与 grep 命令组合使用。如查找含有 usb 关键字的打印信息,就可以使用如下命令:
1 | dmesg | grep usb |
与tail命令结合,查看最后100行
1 | dmesg | tail -n 100 |
kmsg文件
内核所有的打印信息都会输出到循环缓冲区 ‘log_buf’,为了能够方便的在用户空间读取内核打印信息,Linux 内核驱动将该循环缓冲区映射到了/proc 目录下的文件节点 kmsg。
通过cat 或者其他应用程序读取 Log Buffer 的时候可以不断的等待新的 log,所以访问/proc/kmsg的方式适合长时间的读取 log,一旦有新的 log 就可以被打印出来。
首先使用以下命令读取 kmsg 文件,在没有新的内核打印信息时会阻塞
1 | cat /proc/kmsg |
调整内核打印等级
内核的日志打印由相应的打印等级来控制,调用 printk 时,内核会将消息日志级别与当前控制台的日志级别进行比较;如果前者比后者更高(值更低),则消息会立即打印到控制台。
可以这样检查日志级别参数:可以通过调整内核打印等级来控制打印日志的输出。使用以下命令查看当前默认打印等级
1 | cat /proc/sys/kernel/printk |
可以看到内核打印等级由四个数字所决定,“7 4 1 7” 分别对应 console_loglevel、default_message_loglevel、minimum_console_loglevel、default_console_loglevel,具体类型说明如下:
- console_loglevel
- 描述:控制哪些级别的消息可以输出到 终端(console)。
- 规则:只有当消息的 log 优先级 高于 console_loglevel 时,才会在终端显示。
- 举例:“7”表示允许所有级别的消息(0~7)都输出到终端。
- default_message_loglevel
- 描述:
printk函数打印消息时默认的 log 等级(priority)。 - 举例:“4”表示默认打印的消息级别是 警告(warning)。
- 描述:
- minimum_console_loglevel
- 描述:console_loglevel 可以设置的最小值。
- 举例:“1”表示 console_loglevel 最低可以设置为 1,也就是 紧急(emerg)。
- default_console_loglevel
- 描述:内核启动时 console_loglevel 的缺省值。
- 举例:“7”表示缺省情况下允许 所有等级 输出到终端。
include/linux/printk.c
1234567 | int console_printk[4] = { CONSOLE_LOGLEVEL_DEFAULT, /* console_loglevel */ MESSAGE_LOGLEVEL_DEFAULT, /* default_message_loglevel */ CONSOLE_LOGLEVEL_MIN, /* minimum_console_loglevel */ CONSOLE_LOGLEVEL_DEFAULT, /* default_console_loglevel */};EXPORT_SYMBOL_GPL(console_printk); |
include/linux/kern_levels.h
123456789101112131415161718192021222324252627282930313233343536373839 | /* SPDX-License-Identifier: GPL-2.0 *//* * Annotation for a "continued" line of log printout (only done after a * line that had no enclosing \n). Only to be used by core/arch code * during early bootup (a continued line is not SMP-safe otherwise). *//* integer equivalents of KERN_<LEVEL> */ |
| 数字 | 等级名称 | 描述 |
|---|---|---|
| 0 | KERN_EMERG | 紧急,系统不可用 |
| 1 | KERN_ALERT | 警报,需要立即处理 |
| 2 | KERN_CRIT | 严重错误 |
| 3 | KERN_ERR | 一般错误 |
| 4 | KERN_WARNING | 警告 |
| 5 | KERN_NOTICE | 普通但重要信息 |
| 6 | KERN_INFO | 信息性消息 |
| 7 | KERN_DEBUG | 调试消息 |
修改内核打印等级:
123 | echo 0 4 1 7 > /proc/sys/kernel/printk# 如果提示permission denied, 用下面这个命令echo "7 4 1 7" | sudo tee /proc/sys/kernel/printk |
printk 在打印信息前,可以加入相应的打印等级宏定义,具体格式如下所示:
1 | printk(打印等级 "打印信息") |
例如:
1 | printk(KERN_ERR "This is an error\n"); |
如果省略调试级别
printk("This is anerror\n"),则内核将根据CONFIG_DEFAULT_MESSAGE_LOGLEVEL配置选项(这是默认的内核日志级别)向该函数提供一个调试级别。
实际上可以使用以下宏,其名称更有意义,它们是对前面所定义内容的包装 pr_emerg、pr_alert、pr_crit、pr_err、pr_warning、pr_notice、pr_info 和 pr_debug:
1 | pr_err("This is the same error\n"); |
llseek 定位设备驱动
应用层 lseek()
所有打开的文件都有一个当前文件偏移量(current file offset),以下简称为 cfo。cfo 通常是一个非负整数,用于表明文件开始处到文件当前位置的字节数。读写操作通常开始于 cfo,并且使 cfo 增大,增量为读写的字节数。文件被打开时,cfo 会被初始化为 0,除非使用了 O_APPEND 。 使用 lseek 函数可以改变文件的 cfo 。
| 项目 | 说明 |
|---|---|
| 函数定义 | off_t lseek(int fd, off_t offset, int whence); |
| 头文件 | #include <sys/types.h>#include <unistd.h> |
| 参数 fd | 文件描述符 |
| 参数 off_t offset | 偏移量,单位为字节,正负分别表示向前、向后移动 |
| 参数 whence | 位置基点,可选 SEEK_SET(文件开头)、SEEK_CUR(当前指针位置)、SEEK_END(文件末尾) |
| 功能 | 移动文件读写指针;获取文件长度;拓展文件空间 |
| 返回值 | 成功返回新的文件偏移量,失败返回 -1 |
例子:
把文件位置指针设置为 100(开头+100个字节)
1lseek(fd,100,SEEK_SET);把文件位置设置成文件末尾
1lseek(fd,0,SEEK_END);确定当前的文件位置
1lseek(fd,0,SEEK_CUR);
驱动层 llseek()
1 | loff_t (*llseek)(struct file *file, loff_t offset, int whence); |
- 作用:文件指针偏移操作(类似 lseek 系统调用)。
- 参数:
file:文件对象。offset:相对于文件当前位置的偏移量,定义当前位置将改变多少。whence:定义从哪里开始查找,可能取值如下:SEEK_SET:相对于文件开头SEEK_CUR:相对于当前文件指针SEEK_END:相对于文件末尾
- 返回值:
- 新的文件指针位置(
loff_t) - 出错返回负值(如
-EINVAL)
- 新的文件指针位置(
使用步骤
- 使用switch语句检查每种whence情况,因为其取值有限,所以还要相应调整newpos:
12345678910111213 | switch( whence ) { case SEEK_SET:/* 相对于文件开头的位置 */ newpos = offset; /* 偏移成为新位置*/ break; case SEEK_CUR: /* 相对于当前文件的位置 */ newpos = file->f_pos + offset; /* 只需向当前位置添加偏移量 */ break; case SEEK_END: /* 相对于文件结束的位置*/ newpos = filesize + offset; break; default: return -EINVAL;} |
- 检查newpos是否有效:
12 | if ( newpos < 0 ) return -EINVAL; |
- 使用新位置更新f_pos
1 | filp->f_pos = newpos; |
- 返回新的文件指针位置
1 | return newpos; |
示例
123456789101112131415161718192021222324252627282930313233343536373839404142434445464748495051525354555657585960616263646566676869707172737475767778798081828384858687888990919293949596979899100101102103104105106107108109110111112113114115116117118119120121122123124125126127128129130131132133134135136137138139140141142143144145146147148149150151152153154155156157158159160161162163164165166167168169170171172173174 | struct test_drv_data { dev_t dev_num; struct cdev cdev; struct class *class; struct device *dev; struct mutex lock; char kmem[KMEM_SIZE];};static struct test_drv_data *drv_dat;int test_open(struct inode *inode, struct file *file){ file->private_data = drv_dat; return 0;}ssize_t test_read(struct file *file, char __user *buf, size_t size, loff_t *offset){ int ret; struct test_drv_data *dat = file->private_data; size_t len; if (*offset >= KMEM_SIZE) return 0; // EOF len = min(size, (size_t)(KMEM_SIZE - *offset)); ret = mutex_lock_interruptible(&dat->lock); if (ret < 0) { pr_info("test_read is interrupted while acquiring the mutex\n"); return ret; } if (copy_to_user(buf, dat->kmem + *offset, len) != 0) { mutex_unlock(&dat->lock); return -EFAULT; } mutex_unlock(&dat->lock); *offset += len; return len; }ssize_t test_write(struct file *file, const char __user *buf, size_t size, loff_t *offset){ int ret; struct test_drv_data *dat = file->private_data; size_t len = min(size, (size_t)(KMEM_SIZE - *offset)); if (*offset > KMEM_SIZE) return 0; // EOF ret = mutex_lock_interruptible(&dat->lock); if (ret < 0) { pr_info("test_read is interrupted while acquiring the mutex\n"); return ret; } if (copy_from_user(dat->kmem + *offset, buf, len) != 0) { mutex_unlock(&dat->lock); return -EFAULT; } mutex_unlock(&dat->lock); *offset += len; return len;}loff_t test_llseek(struct file *file, loff_t offset, int whence){ loff_t new_offset; switch (whence) { case SEEK_SET: new_offset = offset; break; case SEEK_CUR: new_offset = file->f_pos + offset; break; case SEEK_END: new_offset = KMEM_SIZE + offset; break; default: return -EINVAL; } if (new_offset < 0 || new_offset > KMEM_SIZE) return -EINVAL; file->f_pos = new_offset; return new_offset; // return fixed_size_llseek(file, offset, whence, KMEM_SIZE);}int test_release(struct inode *inode, struct file *file){ return 0;}struct file_operations fops = { .owner = THIS_MODULE, .open = test_open, .read = test_read, .write = test_write, .llseek = test_llseek, .release = test_release,};static int __init llseek_test_init(void){ int ret; drv_dat = kzalloc(sizeof(struct test_drv_data), GFP_KERNEL); if (drv_dat == NULL) { ret = -ENOMEM; goto kzalloc_fail; } ret = alloc_chrdev_region(&drv_dat->dev_num, 0, 1, "test_chrdev_region"); if (ret < 0) goto alloc_chrdev_region; cdev_init(&drv_dat->cdev, &fops); drv_dat->cdev.owner = THIS_MODULE; ret = cdev_add(&drv_dat->cdev, drv_dat->dev_num, 1); if (ret < 0) goto cdev_add_fail; drv_dat->class = class_create(THIS_MODULE, "chrdev"); if (IS_ERR(drv_dat->class)) { ret = PTR_ERR(drv_dat->class); goto class_create_fail; } drv_dat->dev = device_create(drv_dat->class, NULL, drv_dat->dev_num, NULL, "llseek_test%d", 0); if (IS_ERR(drv_dat->dev)) { ret = PTR_ERR(drv_dat->dev); goto device_create_fail; } mutex_init(&drv_dat->lock); return 0;device_create_fail: class_destroy(drv_dat->class);class_create_fail: cdev_del(&drv_dat->cdev);cdev_add_fail: unregister_chrdev_region(drv_dat->dev_num, 1);alloc_chrdev_region: kfree(drv_dat);kzalloc_fail: return ret;}static void __exit llseek_test_exit(void){ device_destroy(drv_dat->class, drv_dat->dev_num); class_destroy(drv_dat->class); cdev_del(&drv_dat->cdev); unregister_chrdev_region(drv_dat->dev_num, 1); kfree(drv_dat);}module_init(llseek_test_init);module_exit(llseek_test_exit);MODULE_LICENSE("GPL");MODULE_AUTHOR("even629<asqwgo@outlook.com>");MODULE_DESCRIPTION("This is a test description for llseek"); |
对于固定缓冲区大小的设备,可直接返回内核已经实现好的fixed_size_llseek(file, offset, whence, KMEM_SIZE);
测试用例:
123456789101112131415161718192021222324252627282930313233343536373839404142434445464748495051525354555657585960616263646566676869707172737475767778798081828384858687888990919293949596979899100101102103104105106107108109110111112113114115116117118119120121 | #include <stdio.h>#include <stdlib.h>#include <unistd.h>#include <fcntl.h>#include <string.h>#include <errno.h>#define DEV_PATH "/dev/llseek_test0"#define BUF_SIZE 64static void dump_buf(const char *tag, const char *buf, ssize_t len){ printf("%s (%zd bytes): \"", tag, len); for (ssize_t i = 0; i < len; i++) { if (buf[i] >= 32 && buf[i] <= 126) putchar(buf[i]); else printf("\\x%02x", (unsigned char)buf[i]); } printf("\"\n");}int main(void){ int fd; char buf[BUF_SIZE]; ssize_t ret; off_t off; printf("open %s\n", DEV_PATH); fd = open(DEV_PATH, O_RDWR); if (fd < 0) { perror("open"); return 1; } /* ================= write ================= */ const char *msg = "Hello llseek test!"; printf("\n[TEST] write \"%s\"\n", msg); ret = write(fd, msg, strlen(msg)); if (ret < 0) { perror("write"); goto out; } printf("write ret = %zd\n", ret); /* ================= SEEK_SET ================= */ printf("\n[TEST] lseek SEEK_SET 0\n"); off = lseek(fd, 0, SEEK_SET); if (off < 0) { perror("lseek SEEK_SET"); goto out; } printf("current offset = %ld\n", off); memset(buf, 0, sizeof(buf)); ret = read(fd, buf, sizeof(buf)); if (ret < 0) { perror("read"); goto out; } dump_buf("read", buf, ret); /* ================= SEEK_CUR ================= */ printf("\n[TEST] lseek SEEK_CUR -6\n"); off = lseek(fd, -6, SEEK_CUR); if (off < 0) { perror("lseek SEEK_CUR"); } else { printf("current offset = %ld\n", off); } memset(buf, 0, sizeof(buf)); ret = read(fd, buf, 6); dump_buf("read", buf, ret); /* ================= SEEK_END ================= */ printf("\n[TEST] lseek SEEK_END -5\n"); off = lseek(fd, -5, SEEK_END); if (off < 0) { perror("lseek SEEK_END"); } else { printf("current offset = %ld\n", off); } memset(buf, 0, sizeof(buf)); ret = read(fd, buf, 5); dump_buf("read", buf, ret); /* ================= EOF ================= */ printf("\n[TEST] read until EOF\n"); off = lseek(fd, 0, SEEK_SET); printf("seek to %ld\n", off); while (1) { ret = read(fd, buf, 8); if (ret == 0) { printf("EOF reached\n"); break; } if (ret < 0) { perror("read"); break; } dump_buf("chunk", buf, ret); } /* ================= invalid lseek ================= */ printf("\n[TEST] invalid lseek (beyond end)\n"); off = lseek(fd, 100, SEEK_SET); if (off < 0) printf("expected error: %s\n", strerror(errno)); else printf("unexpected success, off=%ld\n", off);out: close(fd); return 0;} |
测试:
12345678910111213141516171819202122232425262728 | $ ./test_llseek.oopen /dev/llseek_test0[TEST] write "Hello llseek test!"write ret = 18[TEST] lseek SEEK_SET 0current offset = 0read (32 bytes): "Hello llseek test!\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00"[TEST] lseek SEEK_CUR -6current offset = 26read (6 bytes): "\x00\x00\x00\x00\x00\x00"[TEST] lseek SEEK_END -5current offset = 27read (5 bytes): "\x00\x00\x00\x00\x00"[TEST] read until EOFseek to 0chunk (8 bytes): "Hello ll"chunk (8 bytes): "seek tes"chunk (8 bytes): "t!\x00\x00\x00\x00\x00\x00"chunk (8 bytes): "\x00\x00\x00\x00\x00\x00\x00\x00"EOF reached[TEST] invalid lseek (beyond end)expected error: Invalid argument |
ioctl 设备操作
应用层 ioctl()
| 项目 | 说明 |
|---|---|
| 函数定义 | int ioctl(int fd, unsigned long op, … /* arg */ ); |
| 头文件 | #include <sys/ioctl.h>(可能需要设备相关头文件,如linux/ioctl.h) |
| 参数 fd | 打开的设备文件描述符(如/dev/...) |
| 参数 op | IO 控制命令(通常通过_IO,_IOR,_IOW,_IOWR等宏构建) |
| 参数 arg(可选) | 与 request 命令关联的数据,可以为int*,void*,struct *等 |
| 功能 | 对设备驱动执行控制命令(非数据读写类),用于配置硬件、获取状态、发送控制指令等 |
| 返回值 | 成功:通常为 0(也可能返回其他正值,视 request 而定) 失败:返回 -1,并设置 errno |
上述三个参数中,最重要的是第二个 op参数,为 unsigned int 类型,为了高效的使用 op参数传递更多的控制信息,一个 unsigned int op被拆分为了 4 段,每一段都有各自的意义,unsigned int cmd 位域拆分如下:
12 | | 31 30 | 29 ................ 16 | 15 ...... 8 | 7 .......... 0 || dir | size | type | nr | |
- op[31:30]dir数据(args)的传输方向(读写)
- op[29:16]size数据(args)的大小
- op[15:8]type命令的类型,可以理解成命令的密钥,一般为 ASCII 码(0-255 的一个字符,有部分字符已经被占用,每个字符的序号段可能部分被占用)
- op[7:0]nr命令的序号,是一个 8bits 的数字(序号,0-255 之间)
op 参数由 ioctl 合成宏定义得到,四个合成宏定义如下所示:
- 定义一个命令,但是不需要参数:
12 | _IOC(_IOC_NONE,(type),(nr),0) |
- 定义一个命令,应用程序从驱动程序读参数:
12 | _IOC(_IOC_READ,(type),(nr),(_IOC_TYPECHECK(size))) |
- 定义一个命令,应用程序向驱动程序写参数:
12 | _IOC(_IOC_WRITE,(type),(nr),(_IOC_TYPECHECK(size))) |
- 定义一个命令,参数是双向传递的(先写再读):
1 | |
宏定义参数说明如下所示:
- type:命令的类型,一般为一个 ASCII 码值,称为魔数,一个驱动程序一般使用一个 type
- nr:该命令下序号。一个驱动有多个命令,一般他们的 type,序号不同
- size:args 的类型
例如可以使用以下代码定义不需要参数、向驱动程序写参数、向驱动程序读参数三个宏:
123 |
在 Linux 内核的 ioctl 接口中,每个 ioctl 命令只能传递一个用户空间指针(即一个参数)。但这并不意味着只能传一个整数,可以通过 传递一个结构体指针 来实现“多个参数”。
SIZE = arg 参数的数据结构大小(字节数)它是驱动创建 ioctl 命令码时自动编码进去的。例:
1_IOR('M', 1, int)会自动把:
1sizeof(int) = 4编码进 op。如果是:
1_IOW('M', 2, struct task_info)则:
1sizeof(struct task_info)用户调用
内核收到后:
1copy_from_user(&kernel_buffer, (void __user *)arg, sizeof(struct task_info));
内核源码的 Documentation/driver-api/ioctl.rst中会详细说明。
示例eep_ioctl.h::
123456789101112131415161718192021222324252627 | /** 需要为驱动选择一个数字,以及每个命令的序列号*//** 分区名必须是最大32字节*//** 定义ioctl编号*/ |
驱动层 ioctl()
12 | long unlocked_ioctl(struct file *file, unsigned int cmd, unsigned long arg);long compat_ioctl (struct file *file, unsigned int cmd, unsigned long arg); |
unlocked_ioctl给“本机位宽”的用户程序用
compat_ioctl给“32 位用户程序跑在 64 位内核”用调用未定义的
ioctl命令时返回-ENOTTY错误
内核会用 ioctl 分解宏 解析 cmd:
_IOC_DIR(cmd)—— 数据方向_IOC_TYPE(cmd)—— 设备 magic_IOC_NR(cmd)—— 命令编号_IOC_SIZE(cmd)—— 传递数据大小
示例
123456789101112131415161718192021222324252627282930313233343536373839404142434445464748495051525354555657585960616263646566676869707172737475767778798081828384858687888990919293949596979899100101102103104105106107108109110111112113114115116117118119120121122123124125126127128129130131132133134135136137138139 | struct device_test{ dev_t dev_num; //设备号 int major ; //主设备号 int minor ; //次设备号 struct cdev cdev_test; // cdev struct class *class; //类 struct device *device; //设备 int counter; };static struct device_test dev1;static void fnction_test(struct timer_list *t);//定义function_test定时功能函数DEFINE_TIMER(timer_test,fnction_test);//定义一个定时器void fnction_test(struct timer_list *t){ printk("this is fnction_test\n"); mod_timer(&timer_test,jiffies_64 + msecs_to_jiffies(dev1.counter));//使用mod_timer函数重新设置定时时间}static int cdev_test_open(struct inode *inode, struct file *file){ file->private_data=&dev1;//设置私有数据 return 0;}static int cdev_test_release(struct inode *inode, struct file *file){ file->private_data=&dev1;//设置私有数据 return 0;}static long cdev_test_ioctl(struct file *file, unsigned int cmd, unsigned long arg){ struct device_test *test_dev = (struct device_test *)file->private_data;//设置私有数据 switch(cmd){ case TIMER_OPEN: add_timer(&timer_test);//添加一个定时器 break; case TIMER_CLOSE: del_timer(&timer_test);//删除一个定时器 break; case TIMER_SET: test_dev->counter = arg; timer_test.expires = jiffies_64 + msecs_to_jiffies(test_dev->counter);//设置定时时间 break; default: break; } return 0;}/*设备操作函数*/struct file_operations cdev_test_fops = { .owner = THIS_MODULE, //将owner字段指向本模块,可以避免在模块的操作正在被使用时卸载该模块 .open = cdev_test_open, .release = cdev_test_release, .unlocked_ioctl = cdev_test_ioctl,};static int __init timer_dev_init(void) //驱动入口函数{ /*注册字符设备驱动*/ int ret; /*1 创建设备号*/ ret = alloc_chrdev_region(&dev1.dev_num, 0, 1, "alloc_name"); //动态分配设备号 if (ret < 0) { goto err_chrdev; } printk("alloc_chrdev_region is ok\n"); dev1.major = MAJOR(dev1.dev_num); //获取主设备号 dev1.minor = MINOR(dev1.dev_num); //获取次设备号 printk("major is %d \n", dev1.major); //打印主设备号 printk("minor is %d \n", dev1.minor); //打印次设备号 /*2 初始化cdev*/ dev1.cdev_test.owner = THIS_MODULE; cdev_init(&dev1.cdev_test, &cdev_test_fops); /*3 添加一个cdev,完成字符设备注册到内核*/ ret = cdev_add(&dev1.cdev_test, dev1.dev_num, 1); if(ret<0) { goto err_chr_add; } /*4 创建类*/ dev1. class = class_create(THIS_MODULE, "test"); if(IS_ERR(dev1.class)) { ret=PTR_ERR(dev1.class); goto err_class_create; } /*5 创建设备*/ dev1.device = device_create(dev1.class, NULL, dev1.dev_num, NULL, "test"); if(IS_ERR(dev1.device)) { ret=PTR_ERR(dev1.device); goto err_device_create; }return 0;err_device_create: class_destroy(dev1.class); //删除类err_class_create: cdev_del(&dev1.cdev_test); //删除cdeverr_chr_add: unregister_chrdev_region(dev1.dev_num, 1); //注销设备号err_chrdev: return ret;}static void __exit timer_dev_exit(void) //驱动出口函数{ /*注销字符设备*/ unregister_chrdev_region(dev1.dev_num, 1); //注销设备号 cdev_del(&dev1.cdev_test); //删除cdev device_destroy(dev1.class, dev1.dev_num); //删除设备 class_destroy(dev1.class); //删除类}module_init(timer_dev_init);module_exit(timer_dev_exit);MODULE_LICENSE("GPL v2");MODULE_AUTHOR("topeet"); |
封装驱动提供的API函数
作为驱动工程师的我们当然可以理解每一行代码所要完成的功能,而一般情况下,应用都是由专业的应用工程师来进行编写的,上述代码编写方式很不利于应用工程师的理解和程序的移植,所以对于应用程序 API 的封装是一件必然的事情。
编译成库文件,每个功能函数一个.c文件,每个编译成一个库文件
优化驱动稳定性和效率
检测ioctl命令
ioctl 的 cmd 命令是由合成宏合成得到的,也有相应的分解宏得到各个参数,四个分解宏如下所示:
- 分解 cmd 命令,得到命令的类型:
1 | _IOC_TYPE(cmd) |
- 分解 cmd 命令,得到数据(args)的传输方向:
1 | _IOC_DIR(cmd) |
- 分解 cmd 命令,得到命令的序号:
1 | _IOC_NR(cmd) |
- 分解 cmd 命令,得到数据(args)的大小:
1 | _IOC_SIZE(cmd) |
可以在驱动中通过上述分解宏对传入的 ioctl 命令类型等参数进行判断,从而得到判断传入的参数是否正确,以此优化驱动的稳定性。
检测传递地址是否合理
access_ok()
| 项目 | 说明 |
|---|---|
| 函数原型 | int access_ok(const void __user *addr, unsigned long size); |
| 头文件 | #include <linux/uaccess.h> |
| 参数 addr | 用户空间的指针变量,指向要检查的内存块起始地址 |
| 参数 size | 要检查的内存块大小(字节数) |
| 功能 | 检查指定的用户空间内存块是否可访问(读/写),用于保护内核访问用户空间数据安全 |
| 返回值 | 成功:1(可访问)失败:0(不可访问) |
例子:
1234 | len = sizeof(struct args);if(!access_ok(arg,len)){ return -1;} |
分支预测优化
现在的 CPU 都有 ICache 和流水线机制。即运行当前指令时,ICache 会预读取后面的指令,从而提升效率。但是如果条件分支的结果是跳转到了其他指令,那预取下一条指令就浪费时间了。
likely和unlikely宏
而我们要用到的 likely 和 unlikely 宏,会让编译器总是将大概率执行的代码放在靠前的位置,从而提高驱动的效率。
likely 和 unlikely 宏定义在内核源码include/linux/compiler.h文件中,具体定义如下所示:
12 |
__builtin_expect 的作用是告知编译器预期表达式 exp 等于 c 的可能性更大,编译器可以根据该因素更好的对代码进行优化,所以 likely 与 unlikely 的作用就是表达性 x 为真的可能性更大(likely)和更小(unlikely)。
例子:
123 | if(unlikely(copy_from_user(&test,(int *)arg,sizeof(test)) != 0)){ printk("copy_from_user error\n");} |
驱动调试
debugfs
示例
内核示例arch/arm/mm/ptdump_debugfs.c
123456789101112131415161718192021222324252627282930 | // SPDX-License-Identifier: GPL-2.0static int ptdump_show(struct seq_file *m, void *v){ struct ptdump_info *info = m->private; ptdump_walk_pgd(m, info); return 0;}static int ptdump_open(struct inode *inode, struct file *file){ return single_open(file, ptdump_show, inode->i_private);}static const struct file_operations ptdump_fops = { .open = ptdump_open, .read = seq_read, .llseek = seq_lseek, .release = single_release,};void ptdump_debugfs_register(struct ptdump_info *info, const char *name){ debugfs_create_file(name, 0400, NULL, info, &ptdump_fops);} |
只需要debugfs.h和seq_file.h这两个头文件即可,使用seq_file用于打印更简单。
调试打印
dump_stack()
dump_stack()的作用是:
打印当前 CPU 的调用堆栈(call trace)到内核日志中。
在内核代码中调用它,相当于执行用户态中的backtrace()或者 C 库的printf("%pS", __builtin_return_address())之类的功能。
例子:
12345678 | static int __init helloworld_init(void){ printk(KERN_EMERG "helloworld_init\n"); dump_stack(); return 0;} |
WARN_ON(condition)
WARN_ON (condition)函数作用: 在括号中的条件成立时,内核会抛出栈回溯,打印函数的调用关系。
通常用于内核抛出一个警告,暗示某种不太合理的事情发生了。
WARN_ON 实际上也是调用 dump_stack,只是多了参数 condition 判断条件是否成立,例如 WARN_ON (1)则条件判断成功,函数会成功执行。
例子:
12345678 | static int __init helloworld_init(void){ printk(KERN_EMERG "helloworld_init\n"); WARN_ON(1); return 0;} |
BUG() 和 BUG_ON (condition)
内核中有许多地方调用类似 BUG_ON()的语句,它非常像一个内核运行时的断言,意味着本来不该执行到 BUG_ON()这条语句,一旦 BUG_ON()执行内核就会立刻抛出 oops(只有Linux出现致命错误时会抛出oops),导致栈的回溯和错误信息的打印。
大部分体系结构把 BUG()和 BUG_ON()定义成某种非法操作,这样自然会产生需要的 oops。应用层可以看到产生了段错误。
参数 condition 判断条件是否成立,例如 BUG_ON (1)则条件判断成功,函数会成功执行。
123456789 | static int __init helloworld_init(void){ printk(KERN_EMERG "helloworld_init\n"); BUG_ON(1); return 0;} |
panic (fmt…)
panic (fmt…)函数: 输出打印会造成系统死机并将函数的调用关系以及寄存器值就都打印出来
12345678 | static int __init helloworld_init(void){ printk(KERN_EMERG "helloworld_init\n"); panic("!!!!!!!!!!!!!!!!!!!!!!!!!!!!"); return 0;} |