
时间轴
时间轴
2025-06-22
init
本文介绍了AArch64(ARMv8-A)汇编语言的基础知识。文章首先说明了字节、位及常见C类型(char、short、int)的字节大小,并指出所有AArch64指令宽度为4字节、指针宽度为8字节(但实际地址空间通常小于64位)。随后详细介绍了寄存器体系:x寄存器用于64位整数或指针,w寄存器用于32位整数,d/s寄存器分别用于双精度和单精度浮点数,v寄存器用于SIMD/Neon操作;同时说明了x29为栈帧指针、x30为链接寄存器,以及大返回值通过间接结果位置传递的机制。文章还阐述了寄存器与C类型的对应关系,并强调所有指针存储在x寄存器中。在指令部分,介绍了每条指令固定4字节宽、多数指令有三个操作数,以及方括号表示解引用、感叹号表示前递减等语法。此外,文章重点讲解了内存访问指令ldr/str/ldp/stp的用法,包括普通偏移、后变基和前变基三种寻址模式,并指出未对齐访问会带来性能损失。
前置知识
1 个 byte(字节) 包含 8 个 bit(位)
- char 占 1 个 字节
- short 占 2 个 字节
- int 占 4 个 字节
每个地址代表一个字节的存储单元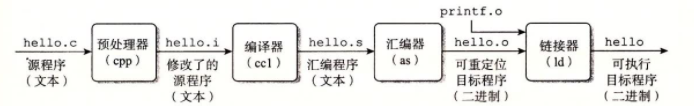
1234 | gcc -E hello.c -o hello.igcc -S hello.i -o hello.sgcc -c hello.s -o hello.ogcc hello.o -o hello |
所有 AARCH64 指令的宽度都是 4 字节。
所有 AARCH64 指针的宽度都是 8 字节†。
严格来说这没错,但在 Linux 系统中通常只使用地址的低 39、42 或 48 位——也就是说,ARM Linux 进程的虚拟地址空间大小小于 64 位。当把地址作为一个 8 字节的值来看待时,高位会被置零。
寄存器
寄存器访问速度
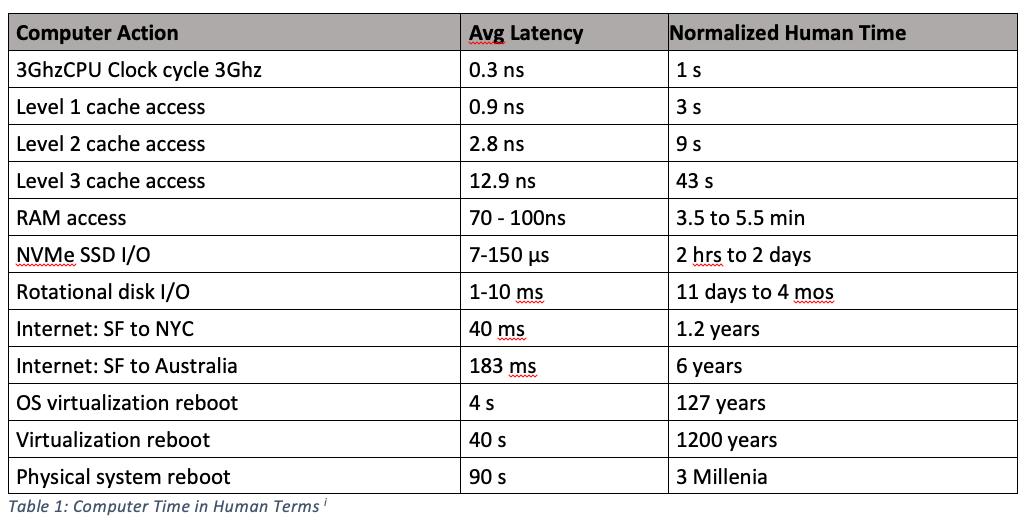
这张图的意思是:如果把访问寄存器(每个 CPU 时钟周期至少能访问一次)比作一秒钟,那么访问 RAM 就像是等待 3.5 到 5.5 分钟。
寄存器类型
- rn 表示“某种类型”的第 n 号寄存器。
寄存器的种类由一个字母指定,而某种类型中的具体哪一个寄存器则由一个数字指定。这也有一些例外。下面是一个入门级的概览:
| 字母 | 类型 |
|---|---|
| x | 64 位整数或指针 |
| w | 32 位_或更小_的整数 |
| d | 64 位浮点数(double,双精度) |
| s | 32 位浮点数(float,单精度) |
部分寄存器类型在此被省略了。
(Chapter 9.1)(Cortex-A Series Programmer’s Guide for ARMv8-A)
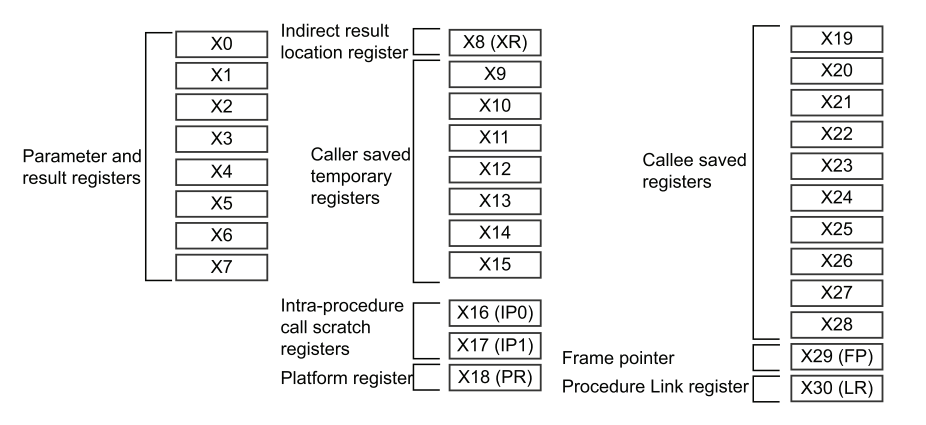
- x29 是栈帧指针(FP)
- x30 是链接寄存器(LR,即返回地址)
- 当函数返回值的类型过大(如超过 64 位,或为大型结构体、联合体),无法通过通用寄存器(X0~X7)直接传递时,调用者会预先分配一块内存作为 “返回结果的存储区域”,并将该区域的地址传递给被调用函数 – 这块内存的地址就是 “Indirect Result Location”。被调用函数执行完毕后,会将结果写入该地址,而非通过寄存器返回。
用于浮点类型(以及向量运算)的寄存器是重合(coincident)的:
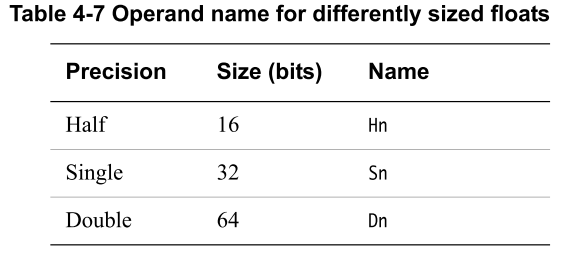
q寄存器宽度为 16 字节——四字(quad words)。(vn 的别名,主要用于SIMD/Neon 指令中)v寄存器宽度也是 16 字节,是q寄存器的同义词。d寄存器用于double(双精度),宽度为 8 字节——双精度。每个v寄存器可容纳 2 个。s寄存器用于float(单精度),宽度为 4 字节。每个v寄存器可容纳 4 个。h寄存器用于半精度浮点数,宽度为 2 字节。每个v寄存器可容纳 8 个。b寄存器用于字节操作。每个v寄存器可容纳 16 个。
寄存器与 C 类型
整数
| 这个声明了一个整数 | 实际上这是一个整数 |
|---|---|
| char | wn |
| short | wn |
| int | wn |
| long | xn |
指针
| 这个声明了一个指针 | 实际上这是一个指针 |
|---|---|
| type * | xn |
所有指针都存储在 x 寄存器中。x 寄存器是 64 位的,但许多操作系统并不支持 64 位地址空间,因为要管理那么大的地址空间本身就需要占用大量空间。相反,操作系统通常使用 48 到 52 位的地址空间。
浮点数
| 这个声明了一个浮点数 | 实际上这是一个浮点数 |
|---|---|
float | sn |
double | dn |
__fp16(half) | hn |
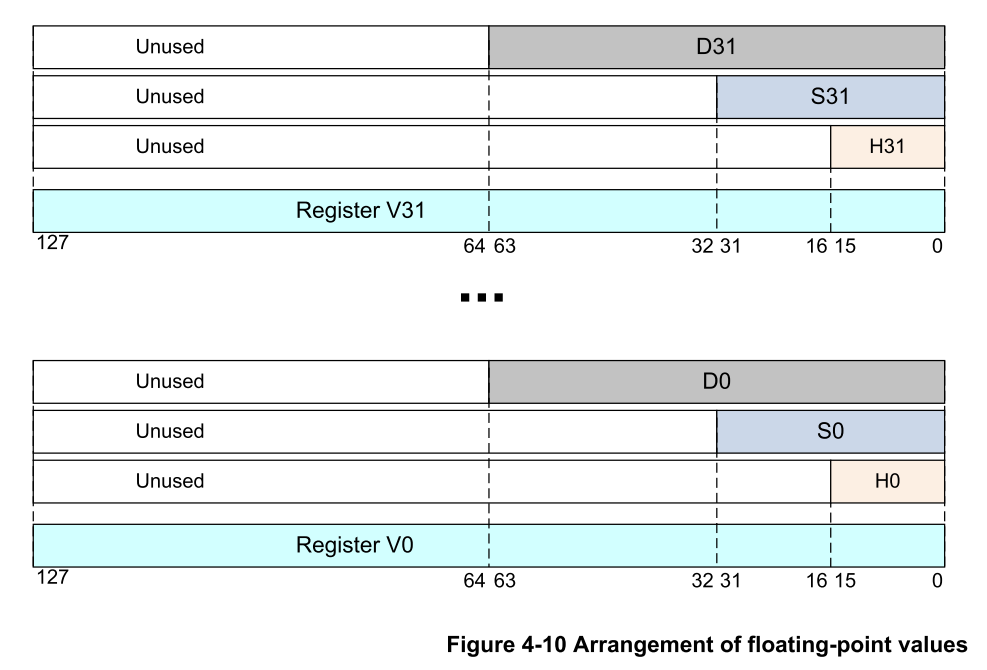
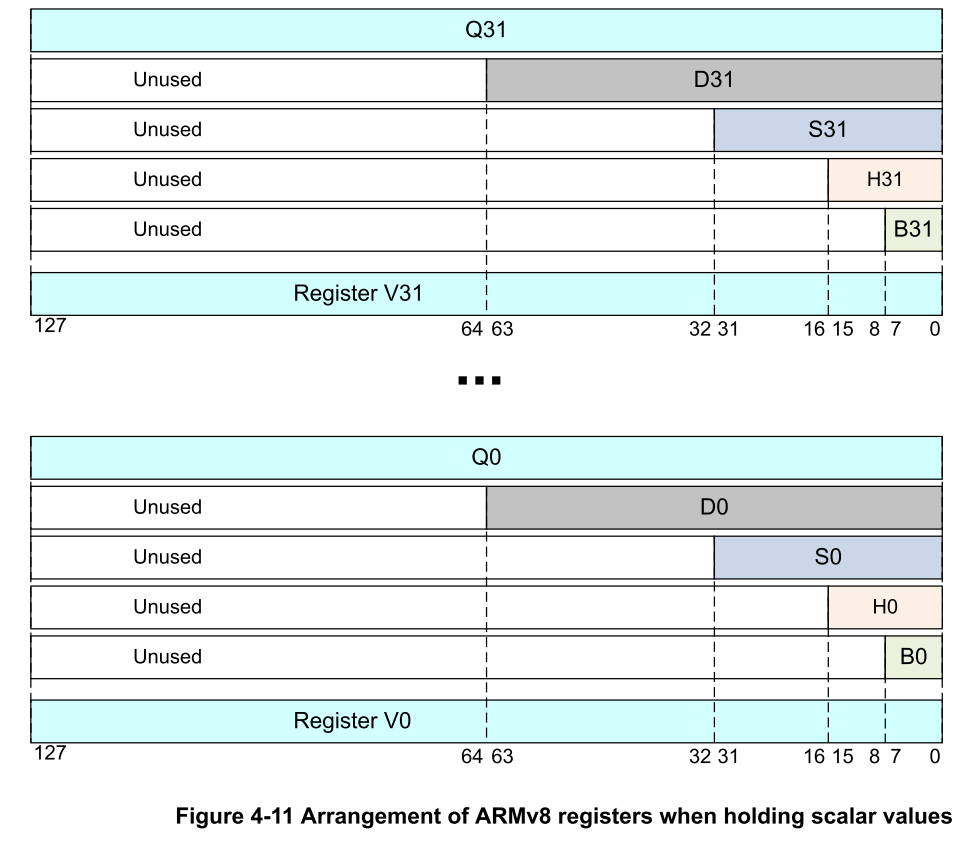
vn 是真正的物理寄存器名,推荐使用, 支持最多类型的访问(浮点 + SIMD)
qn 是 vn 的别名,主要用于SIMD/Neon 指令中(Single Instruction - Multiple Data)
指令
前置知识
每一条 AARCH64 指令都是 4 字节宽。CPU 需要知道的关于这条指令是什么、它可能是哪种变体以及它要使用什么数据的全部信息,都可以在这 4 个字节里找到。
- 大多数(但并非全部)AARCH64 指令有三个_操作数_。它们按如下方式解读:
1 | op ra, rb, rc |
含义是:
1 | ra = rb op rc |
示例:
12 | sub x0, x0, x1 ; means x0 = x0 - x1mov x0, x1 ; means x0 = x1 |
- [ ]
[和]的作用与 C/C++ 中的星号相同,表示“解引用”。它的含义是把方括号里的内容当作一个地址去访问内存。
当 ! 出现在 [] 的末尾时,例如:
123 | stp x21, x30, [sp, -16]!stp x29, x30, [sp, -16]! |
最后,感叹号表示栈指针应该被修改(即对其应用 -16),这是在栈指针的值被用作内存地址(寄存器将被拷贝到的地址)_之前_进行的。再次强调,这是前递减(predecrement)。
含义是:
sp = sp - 16(栈指针向下移动 16 字节)- 把
x29存入[sp],把x30存入[sp + 8]
对应:
1 | ldp x29, x30, [sp], 16 |
含义是:
- 从
[sp]读取 8 字节给x29,从[sp + 8]读取 8 字节给x30 sp = sp + 16(释放栈帧空间)
ARM V8 中栈指针只能以 16 的倍数进行调整。
ARM V8 中栈指针只能以 16 的倍数进行调整。
ARM V8 中栈指针只能以 16 的倍数进行调整。
x29 是栈帧寄存器,但不是必须保存的
内存访问
ldr
load register(加载寄存器)
1234 | ldr x0, [sp] // load 8 bytes from address specified by spldr w0, [sp] // load 4 bytes from address specified by spldrh w0, [sp] // load 2 bytes from address specified by spldrb w0, [sp] // load 1 byte from address specified by sp |
当对 RAM 进行未对齐的访问时,处理器必须放慢速度逐字节地访问。这会带来巨大的性能损失。正确的对齐访问对性能至关重要。
str
store register(存储寄存器)
1234 | str x0, [sp] // store 8 bytes to address specified by spstr w0, [sp] // store 4 bytes to address specified by spstrh w0, [sp] // store 2 bytes to address specified by spstrb w0, [sp] // store 1 byte to address specified by sp |
整数类型之间的类型转换在某些情况下是通过对
255和65535(分别对应char和short)进行and(与)操作来完成的,或者:每当写入寄存器中较窄的部分时,寄存器的其余部分会被清零。也就是说:
ldrb会覆盖x寄存器的最低有效字节,并将高 7 个字节清零。
ldp
load pair(加载一对),与 ldr 相同,但一次加载一对值
stp
store pair(存储一对),与 str 相同,但一次存储一对值
偏移(offsets)
123 | 1) LDR Xt, [Xn|SP{, #pimm}] ; 64-bit general registers2) LDR Xt, [Xn|SP], #simm ; 64-bit general registers, Post-index3) LDR Xt, [Xn|SP, #simm]! ; 64-bit general registers, Pre-index |
simm的范围是 -256 到 255(10 位有符号值)。pimm的范围是 0 到 32760,且必须是 8 的倍数。
三种模式
- 普通偏移模式
1 | LDR Xt, [Xn, #pimm] |
从
Xn + pimm的地址加载数据到Xt;地址寄存器Xn不变;
pimm是一个 正的立即数(positive immediate),必须是 8 的倍数,最大为 32760。
- 后变基模式
1 | LDR Xt, [Xn], #simm |
先用
Xn的原始值作为地址加载数据到Xt,然后再用simm更新Xn;地址寄存器Xn读取内存后改变;
- 前变基模式
1 | LDR Xt, [Xn, #simm]! |
先
Xn = Xn + simm,然后将Xn作为地址加载数据到Xt,地址寄存器Xn读取内存前改变;
伪指令
1 | ldr x1, =label |
汇编器把该标签的地址放进内存中一块被称为“文字池(literal pool)”的特殊区域。关键在于这块内存区域紧挨着(因此距离很近)你的代码之后。
然后,汇编器计算当前指令(即
ldr本身)的地址与文字池中由该标签产生的数据地址之间的差值。汇编器生成一条不同的
ldr指令,它使用数据相对于程序计数器(pc)的差值(或偏移)。这里的pc就是当前指令的地址。由于你的代码对应的文字池就位于代码附近,从当前指令到池中数据的偏移量是一个相对小的数。小到足以塞进一条 4 字节的
ldr指令里。
1 | ldr x1, [pc, offset to in literal pool] |
这种方法的一个缺点是,从中加载地址的文字池位于 RAM 中。这意味着每条这样的
ldr伪指令都会产生一次内存访问。
文字池
对比
12 | ldr x1, =qldr x1, q |
aarch64
1234567891011121314151617181920212223242526 | main // expose main to linker // begin to write code 2 // the code should certainly begin on an even addressmain: str x30, [sp, -16]! ldr x0, =fmt ldr x1, =q ldr x2, [x1] bl printf ldr x0, =fmt ldr x1, q ldr x2, [x1] bl printf ldr x30, [sp], 16 mov w0, wzr ret q: .quad 0x1122334455667788fmt: "address: %p value: %lx\n" |
反汇编这段机器码:
12345678910111213 | 0000000000007a0 <main>: 7a0: f81f0ffe str x30, [sp, #-16]! 7a4: 58000160 ldr x0, 7d0 <main+0x30> 7a8: 58000181 ldr x1, 7d8 <main+0x38> 7ac: f9400022 ldr x2, [x1] 7b0: 97ffffb4 bl 680 <printf@plt> 7b4: 580000e0 ldr x0, 7d0 <main+0x30> 7b8: 580842c1 ldr x1, 11010 <q> 7bc: f9400022 ldr x2, [x1] 7c0: 97ffffb0 bl 680 <printf@plt> 7c4: f84107fe ldr x30, [sp], #16 7c8: 2a1f03e0 mov w0, wzr 7cc: d65f03c0 ret |
以及
123 | 000000000011010 <q>: 11010: 55667788 11014: 11223344 |
它显示
000000000011010 <q>:。这意味着接下来的是源代码中标签q所对应的数据。注意可重定位地址11010。我们将在下面解释“可重定位地址”。现在,看以
7b8开头的那一行反汇编代码。它读作ldr x1, 11010。所以反汇编出的可执行文件在说“去地址 11010 取出它的内容”,也就是我们的1122334455667788。
| 指令 | 含义 |
|---|---|
| ldr r, =label | 加载标签的地址到 r |
| ldr r, label | 加载标签处存储的值到 r |
执行时地址的重定位
我们到目前为止看到的所有地址都不是程序真正运行时将使用的最终地址。所有地址都会被重定位(relocated)。
原因之一是为了防范恶意软件。一种叫做**地址空间布局随机化(ASLR)**的技术,使恶意软件作者无法提前知道该修改你可执行文件的哪里,从而无法达到其不可告人的目的。
64 位 ARM Linux 内核为进程的虚拟地址空间分配 39、42 或 48 位。注意,42 和 48 位的值需要 6 个字节才能容纳。虚拟地址空间是一个进程能够生成/使用的所有地址的集合。此外,进程使用的所有地址都是虚拟地址。
用这种方式可以避免使用文字池
12 | adrp x0, sadd x0, x0, :lo12:s |
示例
加载(存储)不同大小的整数
| 指令 | 含义 |
|---|---|
ldr x0, [x1] | 从x1指定的地址取出一个 64 位的值,放入x0 |
ldr w0, [x1] | 从x1指定的地址取出一个 32 位的值,放入w0 |
ldrh w0, [x1] | 从x1指定的地址取出一个 16 位的值,放入w0 |
ldrb w0, [x1] | 从x1指定的地址取出一个 8 位的值,放入x0 |
- 指针和 long 使用
x寄存器。 - 所有其他大小的整数使用
w寄存器,由指令本身指定大小。
数组索引
123456789 | long Sum(long * values, long length){ long sum = 0; for (long i = 0; i < length; i++) { sum += values[i]; } return sum;} |
注意我们用下标变量i仅仅是为了遍历数组。这(在本例中)效率极其低下。
12345678910 | long Sum(long * values, long length){ long sum = 0; long * end = values + length; while (values < end) { sum += *(values++); } return sum;} |
注意我们不再使用下标变量。相反,我们用指针本身既进行解引用_又_判断何时结束循环。
1234567891011121314151617181920212223 | Sum 4// x0 is the pointer to data// x1 is the length and is reused as `end`// x2 is the sum// x3 is the current dereferenced valueSum: mov x2, xzr // x2 = 0 add x1, x0, x1, lsl 3 // x1 = x0+x1*8 b 2f1: ldr x3, [x0], 8 add x2, x2, x32: cmp x0, x1 blt 1b mov x0, x2 ret |
更快的内存拷贝
假设你需要把 16 字节的内存从一个地方拷贝到另一个地方。你可能会这样做:
12345 | void SillyCopy16(uint8_t * dest, uint8_t * src){ for (int i = 0; i < 16; i++) *(dest++) = *(src++);} |
这尤其愚蠢,因为你明明可以简单地写成下面这样,为什么还要循环 16 次呢:
12345 | void SillyCopy16(uint64_t * dest, uint64_t * src){ *(dest++) = *(src++); // 3 *dest = *src; // 4} |
用 aarch64 实现:
123456 | SillyCopy16: // 1 ldr x2, [x0], 8 // 2 str x2, [x1], 8 // 3 ldr x2, [x0] // 4 str x2, [x1] // 5 ret |
使用 ldp:
1234 | SillyCopy16: ldp x2, x3, [x0] stp x2, x3, [x1] ret |
使用 q 寄存器:
1234 | SillyCopy16: ldr q2, [x0] str q2, [x1] ret |
遍历结构体数组
123456789101112131415161718192021222324252627282930313233343536373839404142434445464748495051 | struct Person{ char * fname; char * lname; int age;};extern int rand();extern struct Person * FindOldestPerson(struct Person *, int);struct Person * OriginalFindOldestPerson(struct Person * people, int length){ int oldest_age = 0; struct Person * oldest_ptr = NULL; if (people) { struct Person * end_ptr = people + length; while (people < end_ptr) { if (people->age > oldest_age) { oldest_age = people->age; oldest_ptr = people; } people++; } } return oldest_ptr;}int main(){ struct Person array[LENGTH]; for (int i = 0; i < LENGTH; i++) { array[i].age = rand() % 5000; } struct Person * oldest = FindOldestPerson(array, LENGTH); for (int i = 0; i < LENGTH; i++) { printf("%d", array[i].age); if (oldest == &array[i]) printf("*"); printf("\n"); }} |
第 11 行告诉我们,在别处有一个名为FindOldestPerson的函数。该函数必须有一个指定了相同名称的.global,以便链接器能够协调对FindOldestPerson的引用。
在-O2或-O3优化下,gcc把OriginalFindOldestPerson()编译成了 18 行汇编。
123456789101112131415161718192021222324252627282930313233343536373839 | FindOldestPerson // 1 // 2 2 // 3 // 4// x0 has struct Person * people // 5// will be used for oldest_ptr as this is the return value // 6// w1 has int length // 7// w2 used for oldest_age // 8// x3 used for Person * // 9// x4 used for end_ptr // 10// w5 used for scratch // 11 // 12FindOldestPerson: // 13 cbz x0, 99f // short circuit // 14 mov w2, wzr // initial oldest age is 0 // 15 mov x3, x0 // initialize loop pointer // 16 mov x0, xzr // initialize return value // 17 mov w5, 24 // struct is 24 bytes wide // 18 smaddl x4, w1, w5, x3 // initialize end_ptr // 19 b 10f // enter loop // 20 // 211: ldr w5, [x3, p.age] // fetch loop ptr -> age // 22 cmp w2, w5 // compare to oldest_age // 23 csel w2, w2, w5, gt // update based on cmp // 24 csel x0, x0, x3, gt // update based on cmp // 25 add x3, x3, 24 // increment loop ptr // 2610: cmp x3, x4 // has loop ptr reached end_ptr? // 27 blt 1b // no, not yet // 28 // 2999: ret // 30 // 31 // 32 .struct 0 // 33p.fn: 8 // 34p.ln: 8 // 35p.age: 4 // 36p.pad: 4 // 37 // 38 // 39 |
控制流
cmp
compare(比较)
丢弃减法的结果,但记录结果究竟是小于、等于还是大于零。它设置条件标志位。
br
Branch to Register(分支到寄存器)
1 | br <register> |
无条件跳转,类似于
1 | goto *(ptr) |
ble
Branch less or equal(小于等于则跳转)
bl
Branch with Link(带链接的跳转)
跳转到一个函数(子程序)地址,并且保存返回地址到x30寄存器中(也叫lr,Link Register)
cbz
Compare and Branch if Zero(比较,若为零则跳转)
1 | cbz <register>, <label> |
如果<register>中的值为 0,就跳转到<label>。
否则继续执行下一条指令。
csel
Conditional Select(条件选择)
1 | csel <dest>, <src1>, <src2>, <condition> |
如果满足<condition>,则将<src1>的值赋给<dest>;
否则将<src2>的值赋给<dest>。
示例:
12 | cmp w2, w5csel w2, w2, w5, gt // 如果 w2 > w5,则 w2 保持不变;否则更新为 w5 |
这是无分支的条件赋值,比if-else更高效。
等价于
1 | w2 = (w2 > w5) ? w2 : w5; |
移位操作
lsl
Logical Shift Left(逻辑左移)
LSL 指令执行乘以 2 的幂。
lsr
Logical Shift Right(逻辑右移)
LSR 指令执行除以 2 的幂。
asr
Arithmetic Shift Right(算术右移)
ASR 指令执行除以 2 的幂,并保留符号位。
ror
rotate right(循环右移)
ROR 指令执行按位旋转,把从最低有效位(LSB)旋转出来的位回绕到最高有效位(MSB)。即:ROR指令执行按位右旋转操作:从最低有效位(LSB)被旋转出来的位,会重新被放入到最高有效位(MSB)的位置中。
位操作
mvn
mvn (Move Not) 作用是 将操作数按位取反(bitwise NOT)后,放入目标寄存器。
orr
orr (bitwise inclusive OR) 对两个操作数执行 按位或(bitwise OR) 运算,然后将结果写入目标寄存器
bfi
bfi (Bit Field Insert) 即“位字段插入”。
1 | bfi <Xd>, <Xn>, #<lsb>, #<width> |
<Xd>:目标寄存器(结果写到这里)<Xn>:源寄存器(从这里取低位的值)<lsb>:目标寄存器中开始插入的起始位(least significant bit 起始位)<width>:要插入多少位(宽度)
假设:
Xd = 0b1111 0000,Xn = 0b1011 (只用低 4 位),lsb=1,width=3
执行:
1 | bfi Xd, Xn, #1, #3 |
结果:
将 Xn 的低 3 位 011 插入 Xd 的位 1~3 上,替换原值结果是 Xd = 1111 0110
ubfm
ubfm = Unsigned BitField Move
基本格式:
1 | ubfm <dst>, <src>, #lsb, #msb |
<dst>:目标寄存器
<src>:源寄存器
lsb:起始位(low bit index)
msb:结束位(high bit index)
这条指令从 src 中 提取一个无符号位字段(即一段连续的比特位),把它放到 dst 的低位(bit 0 开始),其他位清零或忽略也就是说:
- 从 src 的第 lsb 位开始,取到 msb 位
- 将这段 bit 字段提取出来
- 右对齐放到 dst 的低位(bit 0)其他位全部清零
实例:
1 | ubfm w1, w2, #8, #15 |
- 从 w2 中提取 bit 8 到 bit 15(共 8 位)
- 把它放到 w1 的 bit 0~7
ubfiz
ubfiz (Unsigned Bit Field Insert Zeroed) 将一个无符号数的低位字段插入到另一个寄存器的指定位置,但目标寄存器在插入之前会被清零。
它其实是 ubfm(Unsigned Bit Field Move)的一个特化形式,和 UBFM 的语义类似。
指令格式:
1 | ubfiz <dst>, <src>, #lsb, #width |
简单来讲就是:ubfiz = 把 src 的低 width 位 插入到 dst 的 bit lsb 开始的位置,其余位置全部清零。
其中:
<src>:来源寄存器(如 w1)
<dst>:目标寄存器(如 w2),最终结果放在这里
<lsb>:目标中插入位置的起始 bit 位(从 0 开始)
<width>:要插入的位数(从<src>的最低位开始数)
目标寄存器其他位都会被清零。
举例说明:
1 | ubfiz w1, w1, #3, #5 |
含义如下:
- 从 w1 的 最低 5 位(bit 0 到 bit 4)提取出来
- 插入到目标(w1)寄存器的 bit 3 到 bit 7
- w1 的其他所有位(0~2 和 8~31)清零
其他
adr
Address(地址)
adrp
Address of Page(页地址)
12345678 | .rodatafmt: "%p a: 0x%lx b: %x c: %x\n" adrp x0, fmt add x0, x0, :lo12:fmt // 汇编器会自动提取 fmt 的低12位作为立即数,计算页偏移 |
- 作用:把符号
fmt所在的 4KB 对齐页的页地址加载到x0中。 adrp= Address of Page。- 它会忽略符号地址的低 12 位,只保留高位。
- 举例:如果
fmt地址是0x400123,那么adrp x0, fmt会将0x400000加载到x0。 adrp x0, fmt会将fmt地址向下取整到最近的 4KB 边界(即清除低 12 位)
为什么不直接用
ldr x0, =fmt?
- 在 ARM64 下,使用
ldr x0, =fmt可能隐式引入 文字常量池(literal pool),不利于可重定位代码,尤其是在动态链接或 PIE (Position Independent Executable) 环境下。 adrp+add是 推荐的可重定位代码写法(relocatable and PIC-compliant)。- Linux 下的动态链接器(ld.so)支持这种模式更好。
| 指令 | 含义 | 支持的偏移范围 | 常用于 |
|---|---|---|---|
adr | 获取当前指令附近的地址 | ±1MB | 局部跳转、临时变量等 |
adrp | 获取4KB 页对齐的高地址部分 | ±4GB(页对齐偏移) | 获取全局变量地址、字符串、常量表地址等 |
smaddl
Signed Multiply Add Long
两个 32 位整数(有符号) 相乘后,加上一个 64 位整数,结果保存在一个 64 位寄存器中。
1 | smaddl <Xd>, <Wn>, <Wm>, <Xa> |
执行如下操作:
1 | Xd = (int64_t)(int32_t)Wn * (int64_t)(int32_t)Wm + Xa; |
编程
if 语句
if
1234 | if (a > b){ // CODE BLOCK} |
用 aarch64 实现:
123456 | // Assume value of a is in x0 // Assume value of b is in x1 cmp x0, x1 ble 1f // CODE BLOCK1: |
- 如果
a > b,那么x0 - x1将_大于零_。 - 如果
a == b,那么x0 - x1将_等于零_。 - 如果
a < b,那么x0 - x1将_小于零_。
ble 的含义是:如果前一次计算的结果表明“小于或等于”零,则跳转(jump 或 goto)
经验法则
在高级语言中,当条件为真时,你希望_进入_接下来的代码块。
在汇编语言中,当条件为假时,你希望_跳过_接下来的代码块。
临时标签
跳转指令的目标记作1f。这是一个临时标签的例子。
C 和 C++ 中使用大量的大括号。由于标签常常起到等价于{和}的作用,汇编语言中也会使用大量标签。但标签只是一个位置标记,它不是作用域。
临时标签是仅用数字表示的标签。这样的标签可以反复出现(即可以被重复使用)。它们通过相对于使用位置的先后关系来变得唯一。
1f向前(f)查找下一个标签1。1b向后(b)查找最近的标签1。
if / else
12345678 | if (a > b){ // CODE BLOCK IF TRUE}else{ // CODE BLOCK IF FALSE} |
这段代码里内置了两个跳转!
用 aarch64 实现:
123456789 | // Assume value of a is in x0 // Assume value of b is in x1 cmp x0, x1 ble 1f // CODE BLOCK IF TRUE b 2f1: // CODE BLOCK IF FALSE2: |
一个完整的示例
123456789101112131415161718192021222324 | main main: stp x29, x30, [sp, -16]! mov x1, 10 mov x0, 5 cmp x0, x1 ble 1f ldr x0, =T //Pseudo Instruction 伪指令 bl puts b 2f1: ldr x0, =F bl puts2: ldp x29, x30, [sp], 16 mov x0, xzr ret F: "FALSE"T: "TRUE" |
第 11 行是加载标签所代表地址的一种方式。在本例中,标签T对应 C 字符串 “TRUE” 第一个字母的地址。第 15 行加载包含 “FALSE” 的 C 字符串地址。
第 23 行和第 24 行的.asciz是对一种_汇编器伪指令_的调用,用于创建 C 字符串。回忆一下,C 字符串以 NULL 结尾。NULL 结尾由.asciz末尾的z表示。
还有一个类似的伪指令.ascii,它_不会_以 NULL 结尾字符串。
循环
while 循环
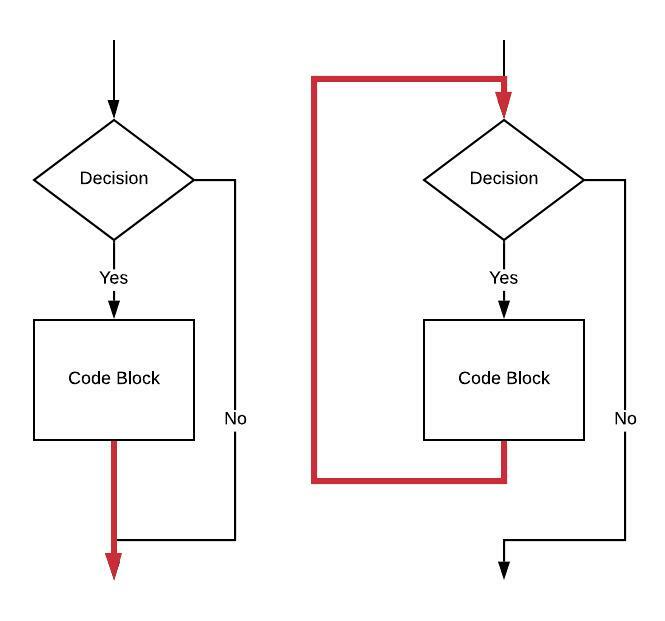
123 | while (a >= b) { // CODE BLOCK} |
aarch64:
123456789 | // Assume value of a is in x0 // Assume value of b is in x1 1: cmp x0, x1 blt 2f // CODE BLOCK b 1b2: |
for 循环
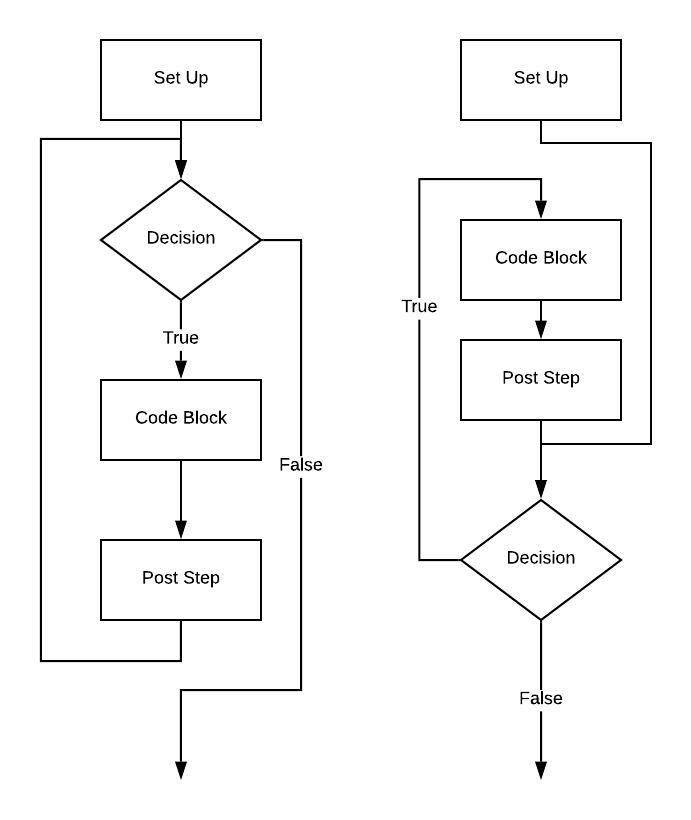
1234 | for (set up; decision; post step){ // CODE BLOCK} |
1234 | for (long i = 0; i < 10; i++){ // CODE BLOCK} |
aarch64(左侧流程图)
123456789101112 | // Assume i is implemented using x0 mov x0, xzr1: cmp x0, 10 bge 2f // CODE BLOCK add x0, x0, 1 b 1b2: |
aarch64(右侧流程图)
123456789101112 | // Assume i is implemented using x0 mov x0, xzr b 2f1: // CODE BLOCK add x0, x0, 12: cmp x0, 10 blt 1b |
continue
123456 | for (long i = 0; i < 10; i++) { // CODE BLOCK "A" if (i == 5) continue; // CODE BLOCK "B"} |
用 aarch64 实现:
123456789101112131415161718 | // Assume i is implemented using x0 mov x0, xzr1: cmp x0, 10 bge 3f // CODE BLOCK "A". // if (i == 5) // continue cmp x0, 5 beq 2f // CODE BLOCK "B"2: add x0, x0, 1 b 1b3: |
另一个版本:
1234567891011121314151617181920 | // Assume i is implemented using x0 mov x0, xzr b 3f1: // CODE BLOCK "A" // if (i == 5) // continue cmp x0, 5 beq 2f // CODE BLOCK "B"2: add x0, x0, 13: cmp x0, 10 blt 1b |
break
break的实现与continue非常相似。
123456 | for (long i = 0; i < 10; i++) { // CODE BLOCK "A" if (i == 5) break; // CODE BLOCK "B"} |
aarch64:
12345678910111213141516171819202122 | // Assume i is implemented using x0 mov x0, xzr b 3f1: // CODE BLOCK "A" // if (i == 5) // break; cmp x0, 5 beq 4f // CODE BLOCK "B"2: add x0, x0, 13: cmp x0, 10 blt 1b4: |
结构体
对齐
数据成员遵循自然对齐(natural alignment)。
即:
- 一个
long会出现在 8 的倍数的地址上。 - 一个
int会出现在 4 的倍数的地址上。 - 一个
short会出现在偶数地址上。 - 一个
char可以出现在任何地址。
示例
12345 | struct { long a; short b; int c;}; |
布局:
| Offset | Width | Member |
|---|---|---|
| 0 | 8byte | a |
| 8 | 2byte | b |
| 10 | 2 | – gap – |
| 12 | 4byte | c |
1234567 | struct Foo { long a; short b; int c;};struct Foo Bar = { 0xaaaaaaaaaaaaaaaa, 0xbbbb, 0xcccccccc }; |
十六进制转储(hex dump)会显示:
1 | aaaa aaaa aaaa aaaa bbbb 0000 cccc cccc |
注意用零填充的间隙。注意,如果这是一个局部变量,这些零可能是垃圾值。
改变顺序:
1234567 | struct Foo { short a; char b; int c;};struct Foo Bar = { 0xaaaa, 0xbb, 0xcccccccc }; |
十六进制转储会显示:
1 | aaaa 00bb cccc cccc |
注意在int c开始之前只有一个字节的间隙。
为什么 b 的左边是零?
因为这台 ARM 处理器运行在_小端序(little endian)_模式下。
定义结构体
1234567 | struct Foo { short a; char b; int c;};struct Foo Bar = { 0xaaaa, 0xbb, 0xcccccccc }; |
这是定义和访问结构体的一种方式:
- 硬编码字段偏移量
1234567891011121314151617181920212223242526272829303132333435 | .rodatafmt: "%p a: 0x%lx b: %x c: %x\n" bar: .short 0xaaaa // a: short 2 byte 0xbb // b: char 1 byte 0x00 // padding 0xcccccccc // c: int 4 byte main 2main: stp x29, x30, [sp, -16]! // 保存栈帧 mov x29, sp adrp x0, fmt add x0, x0, :lo12:fmt // printf 格式字符串地址 adrp x1, bar add x1, x1, :lo12:bar // bar 的地址 ldrh w2, [x1, 0] // short a ldrb w3, [x1, 2] // char b ldr w4, [x1, 4] // int c bl printf // 调用 printf(&bar, a, b, c) // 显式退出系统调用 mov x8, #93 // syscall number for exit mov x0, xzr // exit code 0 svc 0 // make syscall |
:lo12:fmt会被汇编器替换成fmt地址的低 12 位。
adrp x0, fmt会将fmt地址向下取整到最近的 4KB 边界(即清除低 12 位),然后加载这个“页基址”到x0。
例如:
如果fmt = 0x12345678,那么:adrp x0, fmt会得到0x12345000(低 12 位清零)
- another way to define a structs is
使用.equ伪指令定义符号常量
1234567891011121314151617181920212223242526272829303132333435363738394041 | main // main 函数声明 .p2align 2 foo_a, 0 // like #define foo_a 0 foo_b, 2 // like #define foo_b 2 foo_c, 4 // like #define foo_c 4main: stp x29, x30, [sp, -16]! // 保存 x29, x30 到栈上 mov x29, sp // 设置新的帧指针 // 加载 fmt 和 bar 的地址 ldr x0, =fmt // fmt 字符串的地址 ldr x1, =bar // bar 的地址 ldrh w2, [x1, foo_a] // 加载 bar.a 到 w2 ldrb w3, [x1, foo_b] // 加载 bar.b 到 w3 ldr w4, [x1, foo_c] // 加载 bar.c 到 w4 // 调用 printf,传递参数 mov x0, x0 // 第一个参数:fmt 地址 mov x1, w2 // 第二个参数:a 的值 mov x2, w3 // 第三个参数:b 的值 mov x3, w4 // 第四个参数:c 的值 bl printf // 调用 printf // 恢复栈和寄存器 ldp x29, x30, [sp], #16 // 恢复 x29 和 x30 ret // 返回 fmt: "%p a: 0x%lx b: %x c: %x\n" // printf 格式字符串bar: .short 0xaaaa // a 0xbb // b 0 // padding 0xcccccccc // c |
- the third way:(Linux only)
使用.struct和字段标签自动推导偏移
1234567891011121314151617181920212223242526272829303132333435363738394041424344 | .rodatafmt: "%p a: 0x%lx b: %x c: %x\n" // 用 .struct 模拟 struct Foo 的字段偏移 Foo, 0 .struct 0Foo_a: .struct Foo_a + 2 // short a: 2字节Foo_b: .struct Foo_b + 1 // char b: 1字节 .struct Foo_b + 1 // padding: 1字节Foo_c: .struct Foo_b + 2 // int c: 从 offset 4 开始 // 现在 Foo_c 是偏移量 4 bar: .short 0xaaaa // a: short 2 byte 0xbb // b: char 1 byte 0x00 // padding 0xcccccccc // c: int 4 byte main 2main: stp x29, x30, [sp, -16]! // 保存栈帧 mov x29, sp adrp x0, fmt add x0, x0, :lo12:fmt // printf 格式字符串地址 adrp x1, bar add x1, x1, :lo12:bar // bar 的地址 ldrh w2, [x1, Foo_a] // 加载 bar.a(short) ldrb w3, [x1, Foo_b] // 加载 bar.b(char) ldr w4, [x1, Foo_c] // 加载 bar.c(int) bl printf // printf(bar, a, b, c) // 显式退出 mov x8, #93 // syscall number for exit mov x0, xzr // exit code 0 svc 0 // syscall |
使用结构体
总结一下使用struct的要点:
- 所有
struct都有一个基地址 - 基地址对应第一个数据成员的起始位置
- 所有后续数据成员都是相对于第一个成员的偏移
- 为了正确使用
struct,你必须先计算出每个数据成员的偏移量 - 有时数据成员之间会有填充(padding),这是因为需要将所有数据成员对齐到自然边界上。
C++ 中的 this 指针
- 每一个非静态方法调用都使用一个隐藏的第一个参数。就是这样。这就是其中的障眼法。这个隐藏的参数就是 this 指针。
12 | TestClass tc;tc.SetString(test_string); |
看起来我们只传入了一个参数 test_string。但实际上编译器传入了两个参数:
第一个是 this 指针:也就是 tc 的地址,传给寄存器 x0
第二个是 test_string,传给寄存器 x1
在汇编里看到:
123 | adrp x1, _test_stringadrp x0, _tc // 把 tc 对象地址放到 x0 -- 也就是 this 指针bl __ZN9TestClass9SetStringEPc |
const
const的含义和作用只有部分能体现在汇编语言中。
const局部变量和const参数对汇编语言而言和其他数据没什么两样。const局部变量和参数的常量性质完全由编译器实现。const全局变量是由硬件保证其常量性的。试图修改一个以这种方式保护的变量无异于捅马蜂窝。最好别去惹。
switch 与跳转表
当 C++ 优化器开启时,它会分析你的各个 case,并在三种结构之间选择一种来实现你的
switch。而且,它可以使用以下任意组合!编译器作者很聪明!
- 它可能生成一长串
if / else。 - 它可能用_二分查找_找到正确的
case。 - 最后,它可能使用一张跳转表。
假设我们的 case 大致是连续的。鉴于所有跳转指令在字节长度上都相同,我们可以对 switch 变量做一些运算,从而以某种方式推导出我们想要的 case 的地址。
12345678910111213141516171819202122232425262728293031323334353637383940414243444546 | int main(){ int r; srand(time(0)); r = rand() & 7; switch (r) { case 0: puts("0 returned"); break; case 1: puts("1 returned"); break; case 2: puts("2 returned"); break; case 3: puts("3 returned"); break; case 4: puts("4 returned"); break; case 5: puts("5 returned"); break; case 6: puts("6 returned"); break; case 7: puts("7 returned"); break; } return 0;} |
注意在本例中case的值都是连续的。
12345678 | jt: b 0f b 1f b 2f b 3f b 4f b 5f b 6f b 7f |
f表示向前(forward),b表示向后(backward)
在地址jt处有一系列跳转语句……也就是跳转。由于它们是连续排列的,这就是一个跳转表的例子。我们将计算出进入这个_指令数组_的下标,然后跳转到它。
1234 | lsl x0, x0, 2ldr x1, =jtadd x1, x1, x0br x1 |
- 第 2 行加载从地址
jt开始的“指令数组”的基地址。
完整示例
1234567891011121314151617181920212223242526272829303132333435363738394041424344454647484950515253545556575859606162636465666768697071727374757677787980818283 | 4 mainmain: str x30, [sp, -16]! mov x0, xzr // set up call to time(nullptr) bl time // call time setting up srand bl srand // call srand setting up rand bl rand // get a random number and x0, x0, 7 // ensure its range is 0 to 7 // note use of x register is on purpose lsl x0, x0, 2 // multiply by 4 ldr x1, =jt // load base address of jump table add x1, x1, x0 // add offset to base address br x1// If, as in this case, all the "cases" have the same number of// instructions then this intermediate jump table can be omitted saving// some space and a tiny amount of time. To omit the intermediate jump// table, you'd multiply by 12 above and not 4. Twelve because each// "case" has 3 instructions (3 x 4 == 12).// Question for you: If you did omit the jump table, relative to what// would you jump (since "jt" would be gone).jt: b 0f b 1f b 2f b 3f b 4f b 5f b 6f b 7f0: ldr x0, =ZR bl puts b 99f1: ldr x0, =ON bl puts b 99f2: ldr x0, =TW bl puts b 99f3: ldr x0, =TH bl puts b 99f4: ldr x0, =FR bl puts b 99f5: ldr x0, =FV bl puts b 99f6: ldr x0, =SX bl puts b 99f7: ldr x0, =SV bl puts b 99f99: mov w0, wzr ldr x30, [sp], 16 ret .rodataZR: "0 returned"ON: "1 returned"TW: "2 returned"TH: "3 returned"FR: "4 returned"FV: "5 returned"SX: "6 returned"SV: "7 returned" |
实现贯穿(fall through)
如果一个 case 后面的代码没有 break,控制流会直接贯穿到下一个 case。
下面是上面所链接程序的一段代码片段:
1234567 | 0: ldr x0, =ZR bl puts b 99f1: ldr x0, =ON bl puts b 99f |
处理空缺(gaps)
上面的例子展示了 8 个连续的 case。如果 case 4 没有代码会怎样?换句话说,如果 case 4 不存在会怎样?
结果如下:
12345678910111213 | 2: ldr x0, =TW bl puts b 99f3: ldr x0, =TH bl puts b 99f4: b 99f5: ldr x0, =FV bl puts b 99f |
实现 switch 的其他策略
如上所述,优化器至少有三种工具可用于实现复杂的switch语句,并且它可以组合使用这些工具。
- 例如,假设你的 case 归结为两个大致连续的值范围。例如,你有 case 0 到 9,以及 case 50 到 59。你可以将其实现为两个跳转表,并用一个
if / else来选择使用哪一个。
假设你的switch语句中,case值主要集中在两个小的连续范围内,例如:一组是case 0到case 9,另一组是case 50到case 59,那么可以用 两个跳转表 来处理这两个范围,再用一个if / else来决定使用哪一个跳转表。
- 假设你有一个包含很多
case分支的switch语句,而且这些case值之间的数值范围差异很大,比如 case 10, case 1000, case 50000…,那么可以先用二分查找法缩小查找范围,把目标值限制在一个较小的范围内,然后在这个范围内再用其他技术(比如跳转表、线性比较等)来确定最终对应哪个case分支。
假设你有一个包含很多case分支的switch语句,而且这些case值之间的数值范围差异很大,比如 case 10, case 1000, case 50000…,那么可以先用二分查找法缩小查找范围,把目标值限制在一个较小的范围内,然后在这个范围内再用其他技术(比如跳转表、线性比较等)来确定最终对应哪个case分支。
- 你可能需要实现分层跳转表(hierarchical jump tables),例如。
“分层跳转表”是一种优化结构,适用于以下情况:
case值非常稀疏、范围极广(例如case 0, case 1000, case 2000...)- 但它们在局部范围内是稠密的(比如
1000~1009,2000~2009)
你可以:
- 先用一个“一级跳转表”根据高位或区段跳转到一个子跳转表(子范围)。
- 再在子跳转表中做具体跳转。这就构成了一个“分层结构”–像树一样的跳转过程。
实现 if-else 的策略
如果你确实要实现一长串if / else语句,考虑一下某个 case 被选中的频率有多高。把最常见的 case 放在if / else序列的最前面。
这就是所谓的“让常见情况变快(making the common case fast)”。
让常见情况变快是计算机科学中的一个伟大思想。无论你用什么语言,这都是一个值得牢记的思想。
函数
核心概念
bl指令代表 Branch with Link(带链接的跳转)。Link(链接)的概念使得函数(或方法)能够返回到调用之后的下一条指令。
带链接的跳转会计算出它后面那条指令的地址。
它把这个地址放入寄存器
x30,然后跳转到所提供的标签。它留下了一串用来返回的“面包屑”线索中的一环,跟着ret就能返回。
这就是为什么如果你的函数自身又调用了其他函数,就绝对必须在函数内部备份x30。
一个示例
123456789101112 | main 2main: ldr x0, =hw bl puts ret hw: "Hello World!" |
程序会挂起,必须用 ^C 杀掉。
有人调用了main()——它是一个函数,有人用bl指令调用了它。在main()进入的那一刻,它需要返回到的地址正存放在x30中。
然后,main()调用了一个函数——本例中是puts(),但具体调用哪个函数并不重要——它调用了一个函数。在这样做时,它用第 7 行代码的地址覆盖了main()需要返回的地址。那个地址正是puts()需要返回的地方。
所以,当第 7 行执行时,它把x30的内容放入程序计数器并跳转到那里。
下面是修复后的代码:
1234567891011121314 | main 2main: str x30, [sp, -16]! ldr x0, =hw bl puts ldr x30, [sp], 16 ret hw: "Hello World!" |
在 AARCH64 Linux 风格的调用约定中,返回值放在x0中,有时也会放在其他临时寄存器中返回,不过这并不常见。(注意,如果函数返回的是float或double,x0也可能是w0或第一个浮点寄存器。)
如果你的函数调用了_任何_其他函数,x30必须被备份到栈上,然后在返回前恢复到x30。
C 或 C++ 不支持有多个返回值的函数,但在汇编语言中可以写出来——规则由你来打破。
内联函数
声明为 inline(内联)的函数实际上并不进行函数调用。相反,函数的代码经过类型检查后,在调整参数名之后直接插入到“调用”发生的地方。
向函数传递参数
参数如何传递给函数可能因操作系统而异。 本章针对的是 Linux 上实现的标准。
就目前的讨论而言,我们假设所有参数都是long int,因此都存储在x寄存器中。
最多 8 个参数可以直接通过临时寄存器传递。(即
x0到x7)每个参数最大可达地址、long 或 double 的大小(8 字节)。临时(Scratch) 意味着该寄存器的值可以随意改变,而无需在函数调用之间备份或恢复它们的值。
这意味着如果你的函数调用了任何函数,你不能指望临时寄存器的内容保持不变。
一个示例
1234 | long func(long p1, long p2){ return p1 + p2;} |
实现为:
12 | func: add x0, x0, x1 ret |
如果你既是调用者也是被调用者的作者,并且两者都是汇编语言,你可以在返回值上为所欲为。具体来说,你可以返回多个值。但是如果你这样做,你就放弃了从 C 或 C++ 调用这些函数的可能性。
const
1234 | long func(const long p1, const long p2){ return p1 + p2;} |
汇编语言会怎么变?
答案:完全不变!
const是给编译器的指令,命令它禁止更改p1和p2的值。我们是聪明的人类,知道汇编语言根本没打算修改p1和p2,所以无需任何更改。
传递指针
1234 | void func(long * p1, long * p2){ *p1 = *p1 + *p2;} |
12345 | func: ldr x2, [x0] ldr x3, [x1] add x2, x2, x3 str x2, [x0] ret |
由于这是一个void函数,返回时x0的值通常是未定义的。
传递引用
1234 | long func(long & p1, long & p2){ return p1 + p2;} |
1234 | func: ldr x0, [x0] ldr x1, [x1] add x0, x0, x1 ret |
按引用传递同样是对编译器的指令,让它以略微不同的方式对待指针——这种差异在这里体现不出来,所以与传指针版本相比,唯一的区别在于我们如何返回结果。
超过八个参数
1234567891011 | void SillyFunction(long p1, long p2, long p3, long p4, long p5, long p6, long p7, long p8, long p9) { printf("This example hurts: %ld %ld\n", p8, p9);}int main() { SillyFunction(1, 2, 3, 4, 5, 6, 7, 8, 9);} |
123456789101112131415161718192021222324252627282930313233343536373839404142434445 | main/* Demonstration of using more than 8 arguments to a function. This demo is LINUX only as APPLE will put all arguments beyond the first one on the stack anyway. On LINUX, all parameters to a function beyond the eight go on the stack. The first 8 go in registers x0 through x7 as normal (for LINUX).*/SillyFunction: stp x29, x30, [sp, -16]! // Changes sp. mov x29, sp // set new sp ldr x0, =fmt mov x1, x7 // 第八个参数 ldr x2, [sp, 16] // This does not alter the sp,第九个参数 bl printf ldp x29, x30, [sp], 16 // Undoes change to sp. retmain: stp x29, x30, [sp, -16]! // sp down total of 16. mov x29, sp mov x0, 9 str x0, [sp, -16]! // sp down total of 32. mov x0, 1 mov x1, 2 mov x2, 3 mov x3, 4 mov x4, 5 mov x5, 6 mov x6, 7 mov x7, 8 bl SillyFunction add sp, sp, 16 // undoes change of sp by 16 due // to function call. ldp x29, x30, [sp], 16 // undoes change to sp of 16. ret fmt: "This example hurts my brain: %ld %ld\n" |
执行完第 24 行后,栈中的内容为:
12 | sp + 0 former contents of frame pointersp + 8 return address for main |
执行完第 27 行后,栈中的内容为:
1234 | sp + 0 9sp + 8 garbagesp + 16 former contents of frame pointersp + 24 return address for main |
执行完第 14 行后,栈中的内容为:
123456 | sp + 0 return address for SillyFunctionsp + 8 garbagesp + 16 9sp + 24 garbagesp + 32 former contents of frame pointersp + 40 return address for main |
这意味着第 18 行从内存中取出p9并把它的值放进 x2(在那里它成为printf()的第三个参数)。
在 AArch64 中,栈空间常常是 以 16 字节为单位对齐分配的,但你可能 只写了其中的一部分数据,剩下的就没有被初始化,于是我们称它为 “garbage”(未定义的内容)。
ARM V8 中栈指针只能以 16 的倍数进行调整。
ARM V8 中栈指针只能以 16 的倍数进行调整。
ARM V8 中栈指针只能以 16 的倍数进行调整。
调用一些常见 C 运行时函数的示例
顺便说一下,C 运行时中的函数大致分为两类。
一些主要由 C 运行时自身实现。
C 运行时中的另一些函数充当操作系统自身实现的函数的包装器。这些被称为“系统调用(system calls)”。
就调用 C 运行时中的函数而言,这两类函数之间没有实际区别。但要注意,还有使用svc指令直接调用系统调用的方法。
“C runtime”(C 运行时)指的是一组在程序运行时提供支持的函数、变量和基础机制,主要用于支持 C 语言标准库和程序的初始化/终止。这套系统通常被称为 C runtime library(C 运行时库),在不同平台中常见的实现有:
- GNU/Linux 下的 glibc
- Windows 下的 MSVCRT
- macOS 下的 libSystem.dylib(包含 libc)
C runtime 做了哪些事?
- 程序初始化
- 在
main()执行之前,C runtime 会设置好堆栈、初始化全局变量、调用构造函数等。 - 典型入口点是
_start->__libc_start_main()->main()。
- 在
- 提供标准库函数
- 如
printf(),malloc(),exit(),fopen()等,这些函数由 C runtime 实现或封装。
- 如
- 管理资源
- 比如内存分配、文件句柄、线程等的生命周期管理。
- 提供系统调用封装
- 比如你调用
write(),它其实是调用了一个 C runtime 提供的 wrapper,最终通过syscall或svc指令访问内核。
- 比如你调用
系统调用
许多 C 运行时函数只是系统调用的包装器。例如,如果你从 C 运行时调用 open(),该函数会做一些簿记操作,然后执行真正的系统调用。
什么是系统调用?
简短的回答是:系统调用是一种由操作系统自身提供服务的函数调用,它运行在操作系统自己的私有内存区域中,并能访问其内部特性和数据结构。
我们的程序运行在“用户态(userland)”。ARM64 处理器上用户态的技术名称是 EL0(Exception Level 0)。
我们只能通过精心控制的机制——比如系统调用——来操作内核空间。内核(或系统)通常运行所在的技术名称是 EL1。
还有两个更高的异常级别(EL2 和 EL3),超出了本书的范围。
进行系统调用的机制
首先,与任何函数调用一样,需要设置好参数。第一个参数放在第一个寄存器里,以此类推。
其次,把我们希望进行的那个特定系统调用所对应的编号加载到一个特定寄存器(w8)中。
最后,一条特殊指令 svc 引发一个陷阱(trap),把我们从用户态提升到内核空间。换言之,svc 引起从 EL0 到 EL1 的转换。在那里会进行各种检查,并运行系统调用的实际代码。
从系统调用返回的描述超出了本书的范围。提示:就像有一条特殊指令能从 EL0 提升到 EL1 一样,也有一条特殊指令做相反的事。
与特定系统调用关联的编号
参考:
getpid() 示例
1234567 | int main() { printf("Greetings from: %d\n", getpid()); return 0;} |
用汇编语言借助 C 运行时编写:
1234567891011121314151617 | main 2main: stp x29, x30, [sp, -16]! bl getpid mov w1, w0 ldr x0, =fmt bl printf ldp x29, x30, [sp], 16 mov w0, wzr ret fmt: "Greetings from: %d\n" |
最后:直接调用系统调用
123456789101112131415161718 | main 2main: stp x29, x30, [sp, -16]! mov x8, 172 // getpid on ARM64 svc 0 // trap to EL1 mov w1, w0 ldr x0, =fmt bl printf ldp x29, x30, [sp], 16 mov w0, wzr ret fmt: "Greetings from: %d\n" |
我们选择 getpid() 是因为它不需要任何参数。使用 C 运行时时,我们只需 bl 到它。直接调用系统调用则不同,我们必须先把 AArch64 架构下与 getpid() 对应的编号加载到 x8 中。
123456789101112131415161718192021222324252627282930313233343536373839404142434445464748495051525354555657585960616263646566676869707172737475767778798081828384858687888990919293949596979899100101102103104105106107108109110111112113114115116117118119120121122123124125126127128129130131132133134135136137138139140141142143144145146147148149150151152153154155156157158159160161162163164165166167168169170171172173174175176177178179180181182183184185186187188189190191192193194 | /* Perry Kivolowitz Example of file operations.*/ main 2/* This program will * open() a file in the current directory, * write() some text to it, * seek back to the beginning of the file, * read() each line, printing it * close() the file*/// 使用 .req 给寄存器取别名,便于阅读。例如,fd 其实就是 w28,代表文件描述符。retval w27fd w28main: stp x29, x30, [sp, -16]! stp x27, x28, [sp, -16]! bl open_file // w0 will contain either the file descriptor of the new // file or -1 for a failure. Note that the value in w0 // has also been copied to "fd" - a register alias. cmp w0, wzr bge 1f // If we get here, the open has failed. Use perror() to // print a meaningful error and branch to exit. The return // code of the program will be set to non-zero inside fail. ldr x0, =fname bl fail b 99f1: // When we get here, the file is open. Write some data to it. // If write_file returns non-zero, it signifies an error. If // so, branch to the file closing code since the file is open // after printing an error message. bl write_data cbz w0, 10f // If we get here, there was an error in write_data. Print // a reasonable error message then branch to the clean usleep // code. ldr x0, =wf // load legend bl fail // print error b 50f // branch to clean up. // Seek back to position zero preparing to read the file back. // The return value in x0 (off_t) is the return value of // lseek().10: bl seek_zero cbz x0, 20f // If we get here, the seek failed. Cause a reasonable // message to be printed then branch to the clean up code. ldr x0, =sf bl fail b 50f20: // When we get here, we have to read from the file and print // the results. To ignore the complexity of memory allocation // and buffer overrun potential, we'll read one character at a // time looking the end-of-file. // ssize_t read(int fildes, void *buf, size_t nbyte); mov w0, fd ldr x1, =buffer mov x2, 1 bl read // Check the return value - should be 1. cbz x0,50f // zero means EOF - that's OK. // If x0 is negative, that IS a problem. cmp x0, xzr bge 25f // The return value is negative - this is an error. ldr x0, =rf bl fail b 99f25: // Write the character sitting in buffer to the console. mov w0, 1 ldr x1, =buffer mov x2, 1 bl write // We will ignore the return value for the sake of brevity. // There are plenty of examples of handling a potential error // elsewhere in this code. // -- b 20b // When we get here, we are done. Close the file.50: mov w0, fd bl close mov retval, wzr99: ldp x27, x28, [sp], 16 ldp x29, x30, [sp], 16 mov w0, retval ret/* open_file() This function attempts to open a file for both reading and writing. Return values will be checked to ensure the file is opened. If successful, the fd is returned (and is squirreled away in register "fd"). If unsuccessful, the -1 returned by open() is passed back to the caller. Explanation of the magic numbers: int open(const char *pathname, int flags, mode_t mode); octal 102 for flags is O_RDWR | O_CREAT octal 600 for mode is rw------- i.e. read and write for the owner but no permissions for anyone else. There is a version of open() that takes two parameters. However, if O_CREAT is specified, the three parameter version is required.*/ O_FLAGS, 0102 O_MODE, 0600open_file: stp x29, x30, [sp, -16]! ldr x0, =fname mov w1, O_FLAGS mov w2, O_MODE bl open mov fd, w0 ldp x29, x30, [sp], 16 ret/* This function uses perror() to print a meaningful error message in the event of a failure. The string value passed to perror() arrives to us as a pointer in x0.*/fail: stp x29, x30, [sp, -16]! bl perror mov retval, 1 ldp x29, x30, [sp], 16 ret/* ssize_t write(int fd, const void *buf, size_t count); This function will write a string to the file descriptor contained in "fd" (a register alias).*/write_data: stp x29, x30, [sp, -16]! str x20, [sp, -16]! mov w0, fd // file descriptor ldr x1, =txt // address to print from ldr x2, =txt_s // load pointer to size ldr x2, [x2] // dereference the pointer mov w20, w2 // need this value for error check. bl write cmp x0, x20 // Did we write the expected amount? bne 90f // successful write - return 0 mov x0, xzr b 99f90: // failure - ensure we return non-zero! mov x0, 199: ldr x20, [sp], 16 ldp x29, x30, [sp], 16 ret/* off_t lseek(int fd, off_t offset, int whence);*/seek_zero: stp x29, x30, [sp, -16]! mov w0, fd // file descriptor mov x1, xzr // beginning of file mov w2, wzr // SEEK_SET - absolute offset bl lseek ldp x29, x30, [sp], 16 ret prog: "file_ops"wf: "write failed"rf: "read failed"sf: "lseek failed"fname: "test.txt"txt: "some data\n"txt_s: txt_s - txt - 1 // strlen(txt)(不计入结尾的 NULL)buffer: 0 |
浮点数
什么是浮点数?
参考
IEEE 754
寄存器
关于 AARCH64 上的浮点运算有四个最高层级的概念。
- 浮点数值有另一套完整的寄存器组。
- 有专门针对浮点数值的指令。
- 有一些能对一组浮点数值进行运算的特殊指令(SIMD)。
- 有在整数寄存器和浮点寄存器之间来回转换的指令。
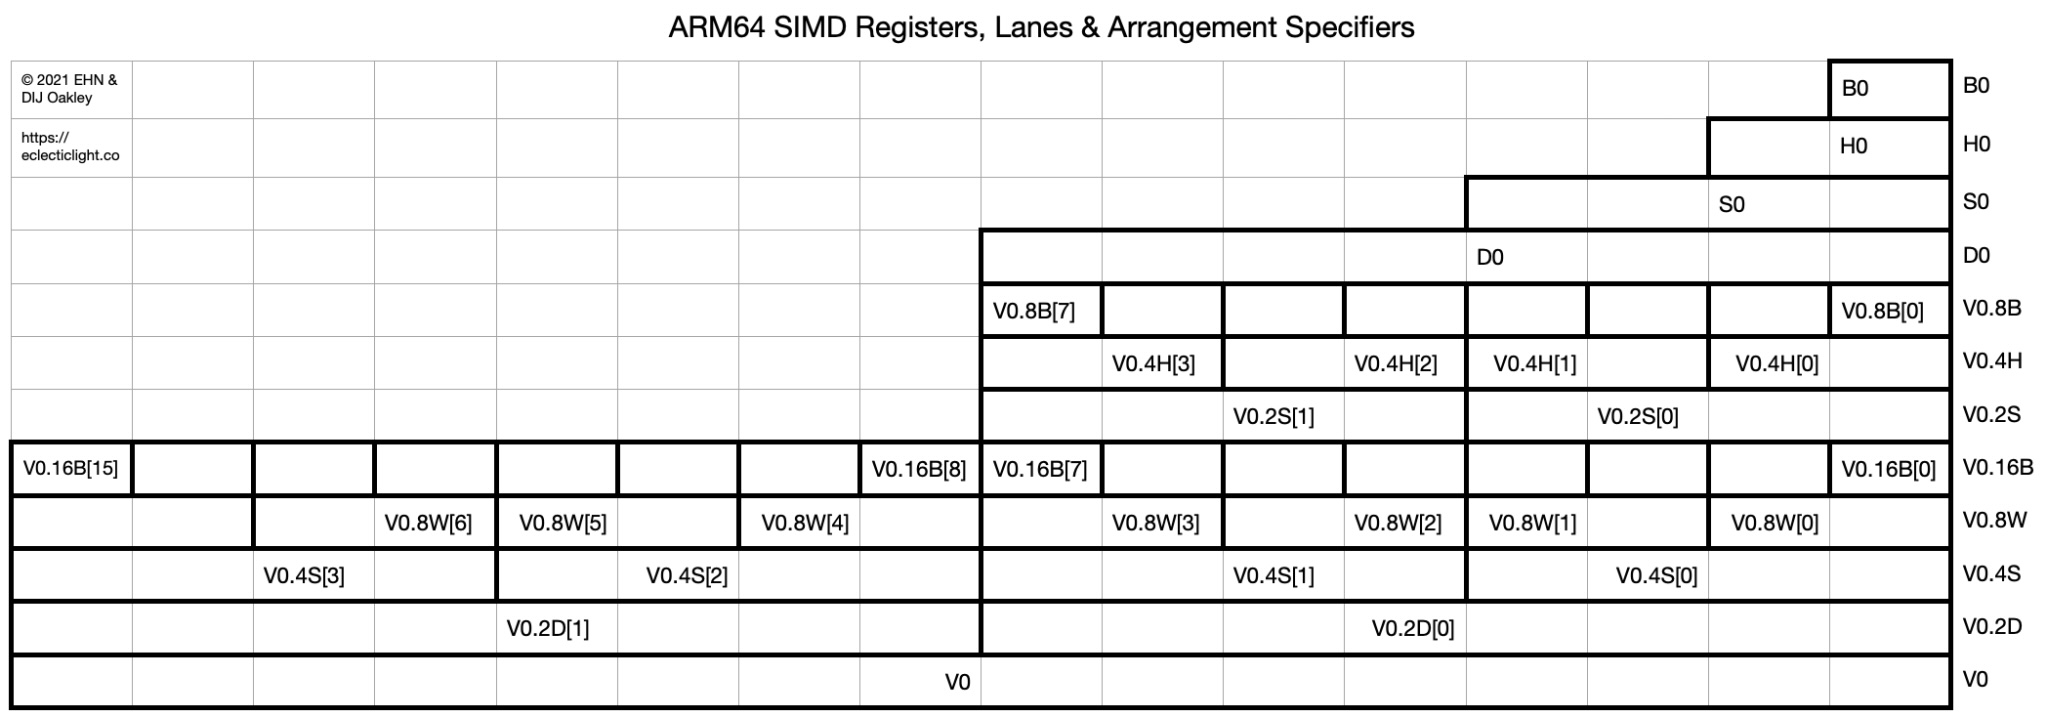
上图展示了 ARM64 架构中 SIMD(Single Instruction, Multiple Data)寄存器 V0 的不同视图与访问方式,包括不同位宽的排列方式(Arrangement Specifiers)与 Lane(通道)索引。
图解说明
这个图以 V0 寄存器为例,展示了 如何用不同的排列方式访问其内容:
| 层级 | 类型 | 说明 |
|---|---|---|
| 最底层 | V0 | 整个 128-bit 的 V0 寄存器 |
| 向上 | V0.2D,V0.4S,V0.8H,V0.16B | 以不同大小的数据视图访问 V0: - D = 64-bit(2 × 64bit) - S = 32-bit(4 × 32bit) - H = 16-bit(8 × 16bit) - B = 8-bit(16 × 8bit) |
| 再上 | V0.2D[0],V0.4S[0]等 | 每个 lane 的索引,比如: - V0.4S[2]表示第 3 个 32-bit 单元- V0.16B[15]表示第 16 个 8-bit 字节 |
| 最上层 | B0,H0,S0,D0 | 是对V0的 alias,按位宽访问(只访问最低位的数据) |
向零截断
truncate(截断)
在 C 和 C++ 中,截断就是我们从下面得到的:
12 | integer_variable = int(floating_variable); // C++integer_variable = (int) floating_variable; // C |
这条指令是 fcvtz——向零转换(convert towards zero)。然后,产生有符号还是无符号结果,由最后一个字母决定:u 或 s。
| 助记符 | 含义 |
|---|---|
| fcvtzu | 截断(始终向 0)产生无符号整数 |
| fcvtzs | 截断(始终向 0)产生有符号整数 |
fcvtzu: Float Convert to Unsigned integer, with truncation toward zerofcvtzs: Float Convert to Signed integer, with truncation toward zero
ARM 文档称这条完全丢弃小数部分的指令所做的是舍入(rounding)而非截断(truncating)。
源寄存器的选择决定了你转换的是 double 还是 single 精度的浮点值。
| 源寄存器 | 转换一个 |
|---|---|
| dX | double到整数 |
| sX | float到整数 |
| 目标寄存器 | 转换一个 |
|---|---|
| xX | 64 位整数 |
| wX | 32 位或更小的整数 |
其中d是double、f是float的示例:
| C++ | 指令 |
|---|---|
int32_t(d) | fcvtzs w0, d0 |
uint32_t(d) | fcvtzu w0, d0 |
int64_t(d) | fcvtzs x0, d0 |
uint64_t(d) | fcvtzu x0, d0 |
示例
123456789101112131415161718192021222324252627282930313233343536373839404142434445464748495051525354555657585960616263646566676869707172737475767778798081828384858687888990919293949596 | main .type main, @function // 表示 告诉汇编器和链接器:main 是一个函数符号(symbol) //.type <symbol>, @<type> 是 GAS(GNU Assembler)的一条伪指令,用于给符号指定类型。 // <symbol>:符号名,比如 main // @<type>:符号类型,这里是 @function,表示这是一个函数,而不是变量或标签main: stp x29, x30, [sp, -16]! // 保存 frame pointer 和 link register mov x29, sp // 保存浮点寄存器 stp d20, d21, [sp, -16]! stp d22, d23, [sp, -16]! // 加载提示信息 ldr x0, =leg bl printf // 加载 vless 数据到 d20-d23 ldr x0, =vless ldr d20, [x0] // dless = 5.49 ldr d21, [x0, #8] // dmore = 5.51 ldr d22, [x0, #16] // ndless = -5.49 ldr d23, [x0, #24] // ndmore = -5.51 // fcvtps: 向上取整(+∞) fcvtps x1, d20 fcvtps x2, d21 ldr x0, =fmt1 bl printf fcvtps x1, d22 fcvtps x2, d23 ldr x0, =fmt1 bl printf // fcvtns: 四舍五入 (tie to even) fcvtns x1, d20 fcvtns x2, d21 ldr x0, =fmt2 bl printf fcvtns x1, d22 fcvtns x2, d23 ldr x0, =fmt2 bl printf // fcvtzs: 向 0 取整 fcvtzs x1, d20 fcvtzs x2, d21 ldr x0, =fmt4 bl printf fcvtzs x1, d22 fcvtzs x2, d23 ldr x0, =fmt4 bl printf // fcvtas: 四舍五入 (tie away from zero) fcvtas x1, d20 fcvtas x2, d21 ldr x0, =fmt3 bl printf fcvtas x1, d22 fcvtas x2, d23 ldr x0, =fmt3 bl printf // 恢复浮点寄存器和返回地址 ldp d22, d23, [sp], #16 ldp d20, d21, [sp], #16 ldp x29, x30, [sp], #16 mov w0, wzr ret .rodatavless: .double 5.49 .double 5.51 .double -5.49 .double -5.51fmt1: "fcvtps less: %ld more: %ld\n"fmt2: "fcvtns less: %ld more: %ld\n"fmt3: "fcvtas less: %ld more: %ld\n"fmt4: "fcvtzs less: %ld more: %ld\n"leg: "less values are +/- 5.49. more values are +/- 5.51.\n" |
注意所有值都被截断成了更接近零的整数。
远离零的截断
远离零的截断没那么简单。事实上,它无法用单条指令完成。
在 C(和 C++)中:
1 | iv = (int(fv) == fv) ? int(fv) : int(fv) + ((fv < 0) ? -1 : 1); |
如果 fv 已经等于一个整数,那么整数值就是这个整数。否则 iv 就是离零更远的那个整数。
在 C++ 中,一个更复杂的版本需要<cmath>,看起来可能是这样:
1234 | template <typename T>int MyTruncate(T x) { return int((x < 0) ? floor(x) : ceil(x));} |
floor() 始终向下截断(趋向更负)。
ceil() 始终向上截断(趋向更正)。
12345678910 | RoundAwayFromZero: fcmp d0, 0 ble 1f // Value is positive, truncate towards positive infinity (ceil) frintp d0, d0 b 2f1: // Value is negative, truncate towards negative infinity (floor) frintm d0, d02: fcvtzs x0, d0 ret |
frintp(Round toward +∞)frintm(Round toward -∞)frintz(Round toward 0)frinta(Round to nearest, tie away from 0)frintn(Round to nearest, tie to even)
舍入转换
rounding(四舍五入)
一条执行我们通常理解的“舍入”操作的指令是 frinta。这是一种“向最近舍入,且平局远离零(to nearest with ties going away)”的转换。所以,5.5 变成 6,正如我们对“舍入”的预期。
把整数转换成浮点值
在 C / C++ 中:
12 | double_var = double(integer_var); // C++double_var = (double)integer_var; // C |
由两条指令处理:
scvtf把有符号整数转换成浮点值ucvtf把无符号整数转换成浮点值
目标寄存器的名字控制了生成哪种浮点值。例如,指定 dX 就生成 double,以此类推。
浮点字面量
回忆一下,所有 AARCH64 指令都是 4 字节长。回忆一下,这意味着对能作为字面量指定的内容有约束,因为字面量必须被编码进 4 字节的指令中。如果字面量太大,会产生汇编器错误。
鉴于浮点值本身至少是 4 字节长,使用浮点字面量受到极大限制。例如:
12 | fmov d0, 1 // 1fmov d0, 1.1 // 2 |
第 1 行能通过,但第 2 行会报错。
要加载一个浮点数,你可以把该值转换成二进制,然后这样做:
12345678910111213141516 | main 2main: str x30, [sp, -16]! ldr s0, =0x3fc00000 fcvt d0, s0 ldr x0, =fmt bl printf ldr x30, [sp], 16 mov w0, wzr ret fmt: "%f\n" |
printf() 只知道如何打印双精度值。当你指定一个 float 时,它会在输出前先将其转换成 double。
人工地把 float 和 double 转换成二进制对人类来说并不常见,尽管编译器很乐意这么做。
对我们人类来说,更常用的是用汇编器伪指令 .float 和 .double 来指定 float 和 double 的值并放入 RAM。一个示例:
1234567891011121314151617181920212223242526272829303132333435363738 | main 2counter x20dptr x21fptr x22 max, 4main: stp counter, x30, [sp, -16]! stp dptr, fptr, [sp, -16]! ldr dptr, =d ldr fptr, =f mov counter, xzr1: cmp counter, max beq 2f ldr d0, [dptr, counter, lsl 3] ldr s1, [fptr, counter, lsl 2] fcvt d1, s1 ldr x0, =fmt add counter, counter, 1 mov x1, counter bl printf b 1b2: ldp dptr, fptr, [sp], 16 ldp counter, x30, [sp], 16 mov w0, wzr ret fmt: "%d %f %f\n"d: .double 1.111111, 2.222222, 3.333333, 4.444444f: .float 1.111111, 2.222222, 3.333333, 4.444444 |
| 指令 | 全称/缩写 | 作用 | 常见用法示例 |
|---|---|---|---|
.req | register require(非官方缩写) | 给寄存器起别名 | foo .req x0表示以后写foo就等于x0 |
.equ | equate | 定义一个常量符号 | BUF_SIZE .equ 64表示BUF_SIZE = 64 |
在 Linux 上,正如 w/x0 到 w/x7 是临时寄存器并用于传递参数一样,s/d0 到 s/d7 也是,且从 0 号寄存器开始。即:
- 整数参数传递:x0 ~ x7(或 32 位的 w0 ~ w7)用于传递前 8 个整数类参数(int、pointer、long 等)。超过 8 个就通过栈传递。
- 浮点参数传递:d0 ~ d7(64 位 double 类型)或 s0 ~ s7(32 位 float 类型)用于传递前 8 个浮点参数。超过 8 个浮点参数也是通过栈传递。
把 32 位塞进 32 位的袋子
1 | ldr s0, =0x3fc00000 // 伪指令!我们以为它直接把 0x3fc00000 加载进 s0 |
编译器不能直接把任意 32 位值硬编码进指令中(因为一条 ARM 指令本身就只有 32 位)。
所以它实际上是:
- 将字面量值 0x3fc00000 写到内存的某个地方(通常靠近当前函数底部)。
- 生成一条 ldr 指令,用 PC-relative load 的方式从这个地址加载该值。这块被称为一个 literal pool,它是一些常量的集合。
我们期望第 6 行读作:
1 | ldr s0, =0x3fc00000 |
实际却是:
1 | b+ 0x784 <main+4> ldr s0, 0x7a0 <main+32> |
向下扫描找到 0x7a0:
1 | 0x7a0 <main+32> .inst 0x3fc00000 ; undefined |
| 伪指令 | 实际效果 | GDB 中看到的实际汇编 |
|---|---|---|
ldr s0, =0x3fc00000 | 把常量加载进s0寄存器 | ldr s0, #literal_addrliteral_addr: .inst 0x3fc00000 |
ldr x0, =fmt | 加载字符串指针地址 | ldr x0, #literal_addrliteral_addr: .inst 地址值 |
.inst 0x3fc00000 | 手动插入一个 32 位数据(不一定是有效指令) | 存放常量(不是执行) |
.inst的含义:
- 全称:
.inst= insert instruction - 用途:直接插入一条 ARM 指令的机器码(通常是 32 位十六进制值)
1 | .inst 0xd65f03c0 // 实际是 ret 指令 |
这个例子中,.inst 后的机器码 0xd65f03c0 是 ret 指令的 32 位编码。也就是说:
1 | ret |
等价于:
1 | .inst 0xd65f03c0 |
在上面的例子中,可以用.inst定义一个地址,从该地址中加载
为什么不用mov reg, #imm?
- mov 有立即数编码限制,不能加载任意 32 位值。
- 超过范围时,必须用 ldr 从内存加载。
fmov
fmov 指令用于在浮点寄存器之间移动浮点值,并在一定程度上在整数寄存器和浮点寄存器之间移动数据。
以立即数形式加载浮点数
正如我们在整数寄存器中看到的那样,有些值可以作为立即数使用,有些则不能。这取决于编码该值需要多少位。位数太多……就塞不进 4 字节指令加上操作码(opcode)了。
例如,这样可以:
1 | mov x0, 65535 |
但这样不行:
1 | mov x0, 65537 |
对 fmov 的立即数约束要严格得多,因为浮点数比整数复杂得多。
fmov d0, #imm能否工作,取决于该浮点数是否能在 8 位编码空间内被精确表示:
| 结构 | 位数 | 说明 |
|---|---|---|
| 符号位 | 1 bit | 表示正或负 |
| 指数部分 | 3 bits | 控制大小(乘以 2 的幂) |
| 尾数部分 | 4 bits | 仅能由 1/2、1/4、1/8、1/16 组合构成 |
123456 | fmov d0, 1.0 // ✅ OK:整数 1 是 2⁰,指数可编码fmov d0, 1.5 // ✅ OK:1 + 0.5 = 2⁰ + 2⁻¹,指数/尾数都能编码fmov d0, 1.75 // ✅ OK:1 + 0.5 + 0.25 = 2⁰ + 2⁻¹ + 2⁻²fmov d0, 1.875 // ✅ OK:+ 2⁻³fmov d0, 1.9375 // ✅ OK:+ 2⁻⁴fmov d0, 1.96875 // ❌ 不行:需要 2⁻⁵,尾数超出 4 位 |
大浮点不能用 fmov,改用 ldr。
fmov 是“位复制器”,不是“精度转换器”。如果要改数值精度,就必须用 fcvt 系列。
半精度
确实支持半精度(16 位)浮点值,但不同编译器如何支持它们尚无完全统一的约定。事实上,存在不止一种而是两种相互竞争的半精度格式:IEEE 类型和 GOOGLE 类型。此外,许多开源开发者还创建了自己的实现,其命名约定可能会产生冲突。
123 | __fp16 Foo(__fp16 g, __fp16 f) { return g + f;} |
编译为:
12345 | fcvt s1, h1fcvt s0, h0fadd s0, s0, s1fcvt h0, s0ret |
注意每个半精度值都被转换成了单精度。因此,在 C 和 C++ 中使用半精度值可能效率低下。
另一方面,如果你愿意使用 intrinsic 和 ARM 提供的某个 SIMD 指令集,那你可以尽情发挥。但要注意,这样做会让你的代码以你可能日后后悔的方式与 ARM 处理器绑定在一起。
位操作
位域(bit field)是 C 和 C++ 语言的一个特性,它完全隐藏了通常所谓的“位敲打(bit bashing)”。
位域中位的顺序在不同平台之间、甚至在同一平台的不同编译器之间都不保证相同。
位域是一种用来在结构体内 精确控制成员所占二进制位数 的语法,通常用于硬件寄存器、协议头等空间敏感的场景。语法格式
1234 | struct 结构体名 { 类型 成员名 : 位宽; ...}; |
示例:
12345 | struct BF { unsigned char a : 1; unsigned char b : 2; unsigned char c : 5;}; |
- a 用 1 位,能表示 0 或 1
- b 用 2 位,能表示 0 ~ 3
- c 用 5 位,能表示 0 ~ 31
三个成员总共占 1 + 2 + 5 = 8 位,即 1 字节
- 虽然每个成员是个位宽,但整体大小通常向整型对齐(这里是 1 字节,因为 8 位正好一字节)。
- 不同编译器对位域对齐和填充细节可能略有差异。
- 访问时可以像普通成员一样:
1234 | struct BF bf;bf.a = 1;bf.b = 3;bf.c = 31; |
编译器会自动对位域进行掩码和移位处理。
考虑一种在 RAM 中可能存在数百万个实例、或在磁盘上数十亿个实例的数据结构。假设每个实例需要 8 个布尔成员。C++ 标准没有定义 bool 的大小,而是留给实现来决定。有些实现把 bool 等同于 int,长度为 4 字节。有些用 char 实现 bool,长度为 1 字节。
我们假设最小的情况,把 bool 等同于 char。我们的结构体可能有数百万或数十亿个实例,需要 8 个 bool,因此是 8 字节。再乘以数百万或数十亿。
位域能在这里帮到你,每个布尔值只用一个位。最好的情况下,8 字节压缩成 1 字节。更糟的情况下,8 × 4 = 32 字节压缩成 1 字节。
假设使用最小单位,即每个 bool 是 1 字节:
12345678910 | struct S { bool b0; bool b1; bool b2; bool b3; bool b4; bool b5; bool b6; bool b7;}; |
这个结构体大小为 8 字节(1 字节 × 8 个 bool)。如果有百万个实例,占用的内存就是 8MB,如果有十亿个实例,则是 8GB。对于 4 字节的 bool 实现,则大小直接变成 32 字节,每亿实例就是 3.2GB。
解决方案:使用位域压缩布尔值
用位域,将 8 个布尔值定义为 1 位大小:
12345678910 | struct S { unsigned char b0 : 1; unsigned char b1 : 1; unsigned char b2 : 1; unsigned char b3 : 1; unsigned char b4 : 1; unsigned char b5 : 1; unsigned char b6 : 1; unsigned char b7 : 1;}; |
8 个 1-bit 成员 合起来正好占 1 字节。
这样 8 字节压缩成 1 字节,节省了大量空间。
在计算机科学中,空间与时间之间始终存在一种永恒的博弈。下面是一条定律:
如果你想让某样东西更快,它将消耗更多内存。
如果你想节省内存,你正在做的事将花费更多时间。
这条定律在这里体现出来……还记得我们想通过把 8 个 bool 压缩成 1 个字节来节省内存的例子吗?为了节省那点内存,我们会变慢,因为访问正确的位需要几条指令,而覆盖一个用 int 实现的 bool 只需一条指令。
至于位域所产生的汇编语言,则取决于优化级别。未优化时,产生的代码会比“精巧的”汇编语言更长更繁琐。
字节序
ARM 两种方式都支持:小端序(little-endian)和大端序(big-endian)。但是:
标准工具链生成的是小端序代码。安装大端序版本的工具链是一项大工程。
下面是来自 Wikipedia 的一段引文:
1 | ARM, C-Sky, and RISC-V have no relevant big-endian deployments, and can be considered little-endian in practice. |
常见的 Intel 处理器也是小端序。
汇编宏
汇编器的一项早期创新是引入了宏(macro)能力。鉴于用汇编写代码有一定程度的繁琐,宏提供了一种简单的元编程形式,一系列语句可以被封装在一个宏里。可以把宏看作是 C++ 模板函数的一种早期形态(差不多,但不完全是)。
下面是一个汇编语言宏的例子:
1234 | .macro LLD_ADDR xreg, label adrp \xreg, \label@PAGE add \xreg, \xreg, \label@PAGEOFF.endm |
它会被展开为:
12 | adrp x0, fmt@PAGEadd x0, x0, fmt@PAGEOFF |
如果 asm 文件以.s结尾,Linux 上的 gcc 不会把汇编语言文件送过 C 预处理器;但如果文件以.S结尾,则会。
通用用法
AASCIZ
AASCIZ label, string
这个宏以 string 作为字符串、label 作为标签来调用 .asciz。此外,这个宏确保字符串从一个 4 字节对齐的边界开始。
PUSH_P, PUSH_R, POP_P 和 POP_R
这些宏省去了一些重复的敲击。例如:
1 | PUSH_P x29, x30 |
展开为:
1 | stp x29, x30, [sp, -16]! |
START_PROC 和 END_PROC
把 START_PROC 放在引入一个函数的标签之后。
把 END_PROC 放在函数最后一个 ret 之后。
它们分别展开为:.cfi_startproc 和 .cfi_endproc。
MIN 和 MAX
用于求最小值和最大值、更易读的便捷宏。注意,该宏执行一次 cmp,它会从 src_a 中减去 src_b(丢弃结果),目的是设置标志位,供随后的 csel 解读。
签名:
1 | MIN src_a, src_b, dest |
src_a 和 src_b 中较小者被放入 dest。
签名:
1 | MAX src_a, src_b, dest |
src_a 和 src_b 中较大者被放入 dest。
MOD
上面用到的 MOD 宏定义为:
1234 | .macro MOD src_a, src_b, dest, scratch sdiv \scratch, \src_a, \src_b msub \dest, \scratch, \src_b, \src_a.endm |
GLABEL
把一个标签标记为全局,使该标签可被外部使用。
签名:
1 | GLABEL label |
会前置一个下划线。
CRT
调用 CRT(C runtime)函数如果你创建自己的函数且没有下划线,照常调用即可。如果你需要调用诸如 C 运行时库中的函数,按如下方式使用这个宏:
1 | CRT strlen |
MAIN
声明 main()
把 MAIN 单独放在一行。注意没有冒号。
errno
外部定义的 errno 是通过一个 CRT 函数来访问的,在用 C 和 C++ 编码时看不到这个函数。该函数在 Mac 和 Linux 上的名字不同。要获取 errno 的地址,使用:
1 | ERRNO_ADDR |
这个宏进行正确的 CRT 调用,并把 errno 的地址留在 x0 中。
加载与存储
GLD_PTR
加载一个标签的地址然后解引用它,其中在 Apple 上该标签位于全局空间,在 Linux 上是一个相对较近的标签。
签名:
1 | GLD_PTR xreg, label |
当这个宏完成时,指定的 x 寄存器中存放着指定标签处那个 64 位值。
GLD_ADDR
把标签的地址加载到指定的 x 寄存器中。不进行解引用。在 Apple 机器上,该标签将在全局空间中找到。
签名:
1 | GLD_ADDR xreg, label |
当这个宏完成时,标签的地址在 x 寄存器中。
LLD_ADDR
与 GLD_ADDR 类似,这个宏加载一个“局部”标签的地址。
签名:
1 | LLD_ADDR xreg, label |
当这个宏完成时,标签的地址在 x 寄存器中。
LLD_DBL
签名:
1 | LLD_DBL xreg, dreg, label |
当这个宏完成时,位于指定局部标签处的 double 将存放在指定的 double 寄存器中。
LLD_FLT
签名:
1 | LLD_FLT xreg, sreg, label |
当这个宏完成时,位于指定局部标签处的 float 将存放在指定的单精度寄存器中。
性能
撤销栈指针的修改
一个关于撤销栈指针修改的小技巧。你可能会认为,用 str 或 stp 及其同类压栈所做的栈修改,必须用 ldr 或 ldp 及其同类来撤销。
这要视情况而定。
如果你需要取回压入栈中的寄存器原始内容,那么用 ldr 或 ldp 是合适的。然而,如果你不需要取回寄存器的原始内容,那么用加法来撤销栈的修改会更快。
以 printf() 的使用为例。在 Apple Silicon 系统上,你必须通过压栈把参数传给 printf()。然而,当 printf() 完成时,你并不需要你压入的那些值。如上所示,只需把正确的值(16 的倍数)加到栈指针上即可。这更快,因为加法不会像 ldr 那样访问 RAM(或缓存)。
其他
让汇编器自己计算长度
1234567891011121314151617181920212223242526272829 | main 2 main: str x30, [sp, -16]! mov w0, 1 // stdout ldr x1, =s // pointer to string ldr x2, =ssize // pointer to computed length ldr w2, [x2] // actual length of string bl write ldr x0, =fmt ldr x1, =s ldr x2, =ssize ldr w2, [x2] bl printf ldr x30, [sp], 16 mov w0, wzr ret s: "Hello, World!\n"ssize: ssize - s - 1 // accounts for null at endfmt: "str: %slen: %d\n" // accounts for newline |
原子操作
链接加载,条件存储
123456789101112131415 | .p2align 2#if defined(__APPLE__) _LoadLinkedStoreConditional_LoadLinkedStoreConditional:#else LoadLinkedStoreConditionalLoadLinkedStoreConditional:#endif1: ldaxr w1, [x0] add w1, w1, 1 stlxr w2, w1, [x0] cbnz w2, 1b ret |
LL/SC 是一种乐观并发控制机制。它大致逻辑是:
Load-Linked(LDAXR):加载一个地址的值,并“观察”该地址是否被改动。你可以修改这个值(如加 1)。
Store-Conditional(STLXR):尝试写这个新值,如果在这之间地址内容没有被别人改过,则写入成功;否则失败。成功与否会通过 STLXR 的返回值告诉你(0 表示成功,非 0 表示失败)。
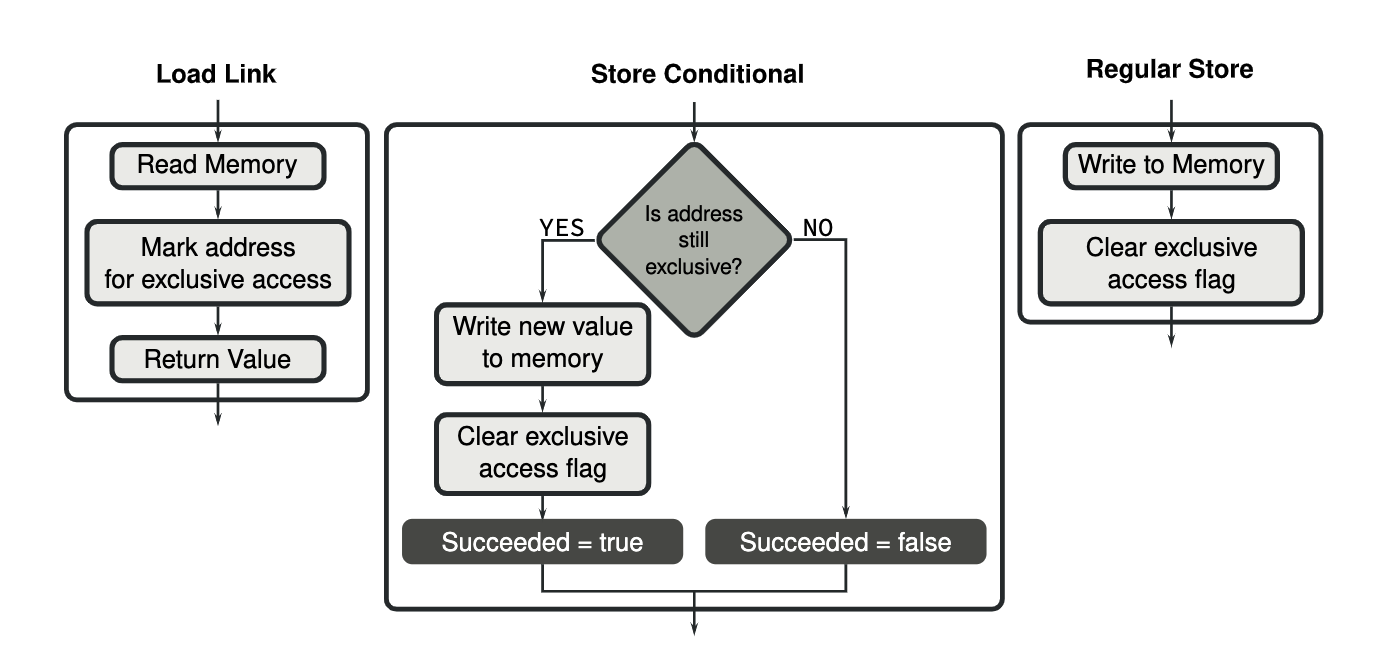
在 ARMv8 的第二个版本(称为 ARMv8.1)中,原子变量上的操作实现得到了改进。链接加载和条件存储指令仍然可用,但新增了几条指令,能够在单条原子指令中执行加法、减法以及各种位运算。
例如:
12 | mov w1, 1ldaddal w1, w0, [x0] |
所做的工作相同:原子地把 x0 所指向的内存中的值加一。
自旋锁(spin-lock)
下面是 ARM V8 自旋锁的源代码。
加锁(Lock)
123456789 | Lock: START_PROC mov w3, 1 // 准备存储的值:1 表示“加锁”1: ldaxr w1, [x0] // 原子加载并标记 exclusive 访问 cbnz w1, 1b // 如果锁不为 0(被别人持有),继续自旋 stlxr w2, w3, [x0] // 尝试原子写入,成功则 w2=0 cbnz w2, 1b // 如果失败(有竞争),继续自旋 ret END_PROC |
stlxr: 如果 exclusive tag 还有效(没人抢走锁),那么将 w3 的值写入*x0,并将结果放入 w2(0 表示成功)
- ldaxr dereferencing the lock itself (once again an int32_t) and marks the location of the lock as being hopefully, exclusive.
- Having gotten the value of the lock, its value is inspected and if found to be non-zero, we branch back to attempting to get it again - this is the spin.
- If the contents of the lock is 0, its value in w1 is changed to non-zero. Note, this could be made a bit better if a value of 1 was stored in another w register and simply used directly on line 10.
stlxr w2, w3, [x0]conditionally stores the changed value back to the location of the lock. If the stlxr returns 0, we got the lock. If not, we start over - somebody else got in there ahead of us. Perhaps this happened because we were descheduled. Perhaps we lost the lock to another thread running on a different core.
解锁(unlock)
123456 | Unlock: START_PROC str wzr, [x0] // 写 0 表示释放锁 dmb ish // 内存屏障,跨核同步 ret END_PROC |
All it does is set to value of the lock to zero. The correct operation of the lock requires that no bad actor simply stomps on the lock by calling Unlock without first owning the lock. Just say no to lock stompers.
dmb ishsets up a data memory barrier across each processor - it makes sure threads running on different cores see the update correctly. This code seemed to work without this line but intuition suggests it could be important. In Lock() the stlxr instruction has an implied data memory barrier.
总结(伪代码角度)
- Lock(x0):
12345 | do { w1 = *x0; // atomic exclusive load if (w1 != 0) continue; result = atomic_store_exclusive(x0, 1); // try to set lock} while (result != 0); // someone else beat us |
- Unlock(x0):
12 | *x0 = 0; // unlockdmb(ISH); // ensure all cores see the update |